# ViLT
## 概述
ViLT 模型由 Wonjae Kim、Bokyung Son 和 Ildoo Kim 在 [ViLT: Vision-and-Language Transformer Without Convolution or Region Supervision](https://huggingface.co/papers/2102.03334) 中提出。ViLT 将文本嵌入整合到 Vision Transformer (ViT) 中,使其能够以极简的设计实现视觉与语言预训练 (VLP)。
该论文的摘要如下:
*视觉-语言预训练(VLP)提升了多种视觉-语言联合下游任务的性能。当前的 VLP 方法严重依赖图像特征提取过程,其中大多数涉及区域监督(例如目标检测)和卷积架构(例如 ResNet)。尽管文献中未予重视,但我们发现这在(1)效率/速度方面存在问题,因为仅提取输入特征所需的计算量就远大于多模态交互步骤;以及(2)表达能力方面存在问题,因为其上限受限于视觉嵌入器的表达能力及其预定义的视觉词汇表。在本文中,我们提出了一个极简的 VLP 模型——视觉-语言 Transformer(ViLT),其“单体”特性体现在视觉输入的处理被大幅简化,采用与文本输入完全相同的无卷积处理方式。我们证明,ViLT 比以往的 VLP 模型快数十倍,同时在下游任务上具有竞争力或更优的性能。*
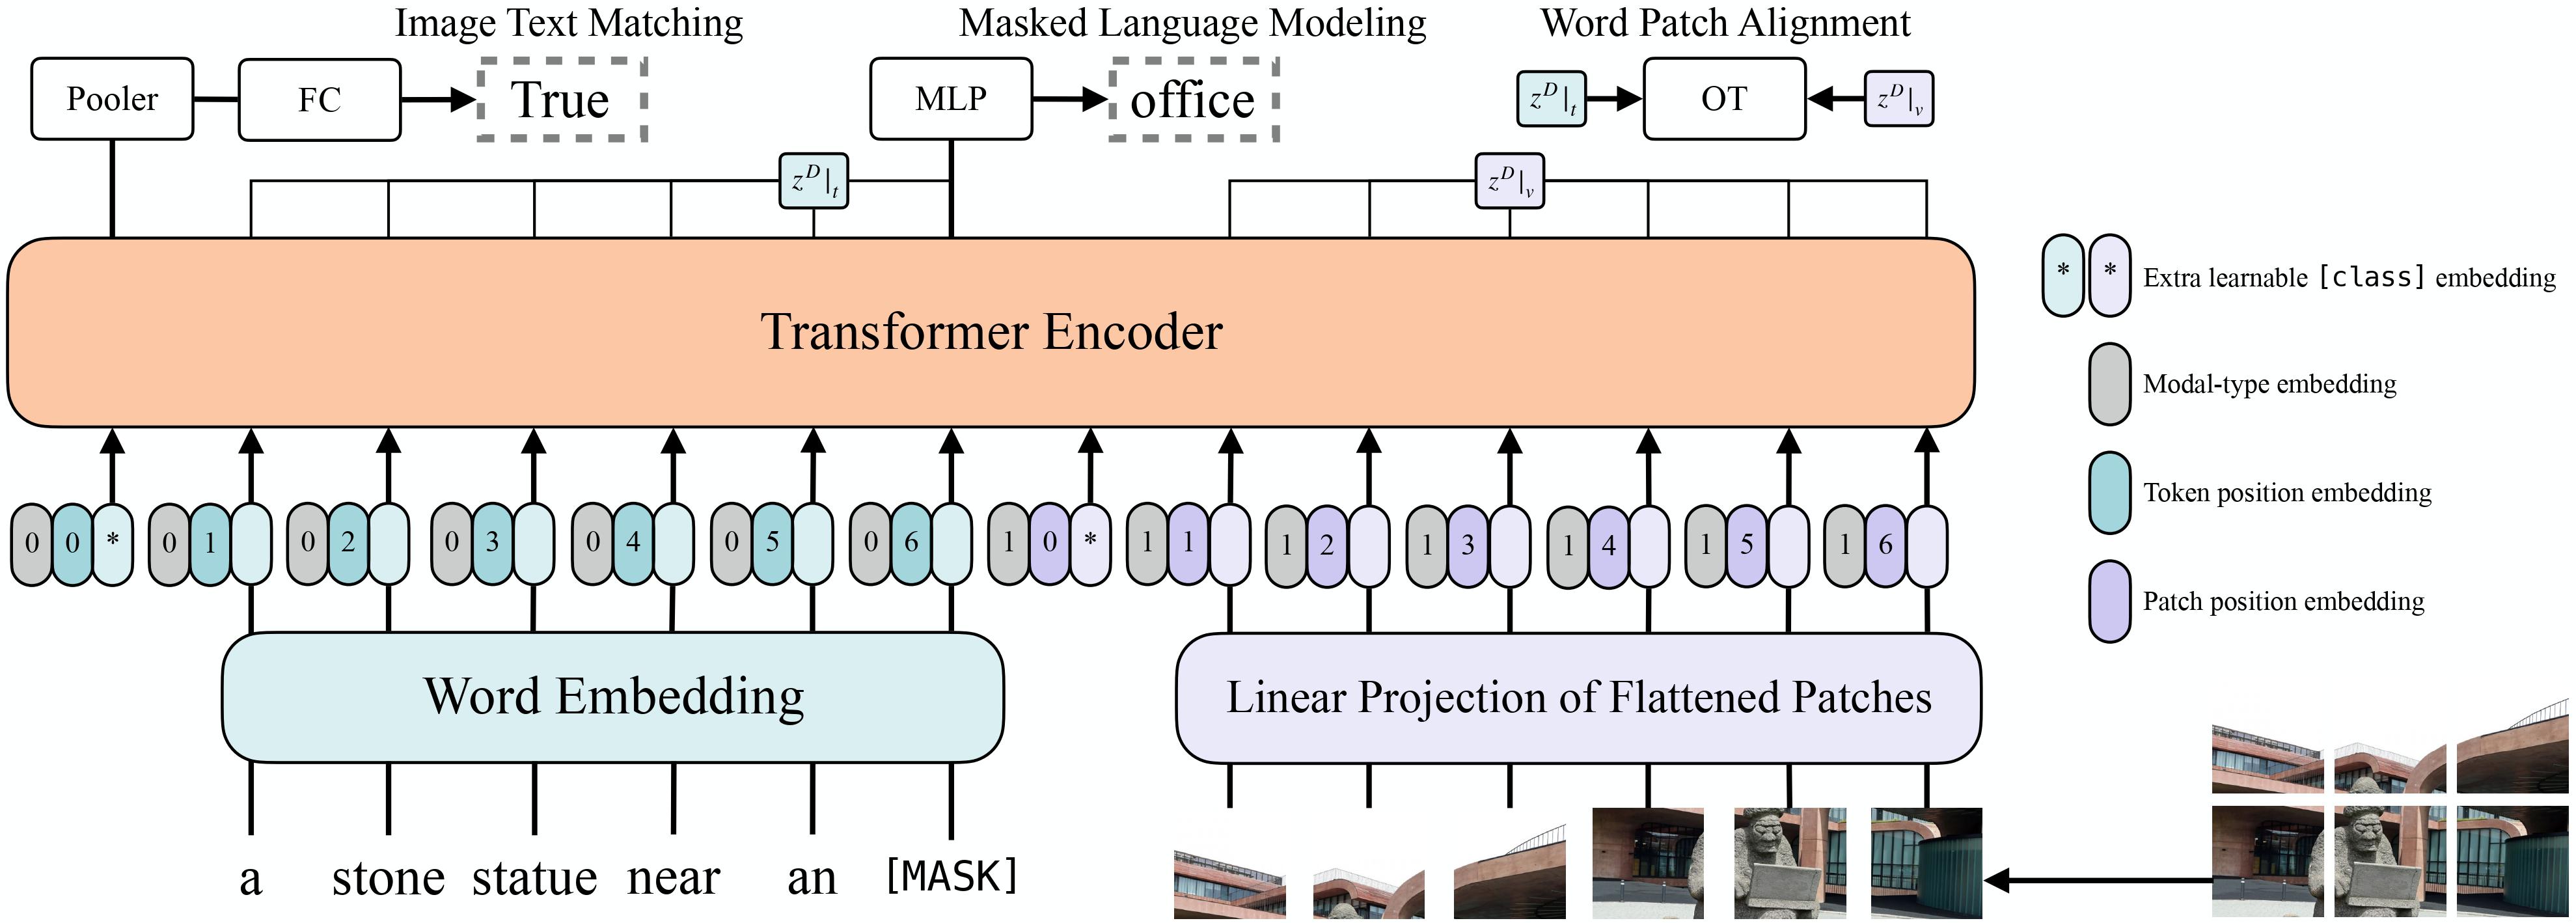 ViLT 架构。摘自原始论文。
该模型由 [nielsr](https://huggingface.co/nielsr) 贡献。原始代码可在[此处](https://github.com/dandelin/ViLT)找到。
## 使用技巧
- 快速上手 ViLT 的方法是查看[示例笔记本](https://github.com/NielsRogge/Transformers-Tutorials/tree/master/ViLT)(其中展示了推理以及在自定义数据上进行微调)。
- ViLT 是一个同时接受 `pixel_values` 和 `input_ids` 作为输入的模型。可以使用 [ViltProcessor](/docs/transformers/v5.23.0/zh/model_doc/vilt#transformers.ViltProcessor) 为模型准备数据。该处理器将图像处理器(用于图像模态)和分词器(用于语言模态)封装在一起。
- ViLT 使用各种尺寸的图片进行训练:作者将输入图像的短边调整为 384,并在保持宽高比的同时将长边限制在 640 以内。为了使图像能够进行批处理,作者使用 `pixel_mask` 来指示哪些像素值是真实的,哪些是填充值。[ViltProcessor](/docs/transformers/v5.23.0/zh/model_doc/vilt#transformers.ViltProcessor) 会自动为您创建此掩码。
- ViLT 的设计与标准的 Vision Transformer (ViT) 非常相似。唯一的区别在于,该模型为语言模态包含了额外的嵌入层。
## ViltConfig[[transformers.ViltConfig]]
#### transformers.ViltConfig[[transformers.ViltConfig]]
```python
transformers.ViltConfig(transformers_version: str | None = None, architectures: list[str] | None = None, output_hidden_states: bool | None = False, return_dict: bool | None = True, dtype: str | torch.dtype | None = None, chunk_size_feed_forward: int = 0, is_encoder_decoder: bool = False, id2label: dict[int, str] | dict[str, str] | None = None, label2id: dict[str, int] | dict[str, str] | None = None, problem_type: Literal['regression', 'single_label_classification', 'multi_label_classification'] | None = None, vocab_size: int = 30522, type_vocab_size: int = 2, modality_type_vocab_size: int = 2, max_position_embeddings: int = 40, hidden_size: int = 768, num_hidden_layers: int = 12, num_attention_heads: int = 12, intermediate_size: int = 3072, hidden_act: str = 'gelu', hidden_dropout_prob: float | int = 0.0, attention_probs_dropout_prob: float | int = 0.0, initializer_range: float = 0.02, layer_norm_eps: float = 1e-12, image_size: int | list[int] | tuple[int, int] = 384, patch_size: int | list[int] | tuple[int, int] = 32, num_channels: int = 3, qkv_bias: bool = True, max_image_length: int = -1, tie_word_embeddings: bool = True, num_images: int = -1, pad_token_id: int | None = None)
```
[来源](https://github.com/huggingface/transformers/blob/v5.23.0/src/transformers/models/vilt/configuration_vilt.py#L24)
**参数:**
vocab_size (`int`,*可选*,默认值为 `30522`):模型的词汇表大小。定义了 `input_ids` 可以表示的不同 token 数量。
type_vocab_size (`int`,*可选*,默认为 `2`):`token_type_ids` 的词汇表大小。
modality_type_vocab_size (`int`, *可选*,默认为 2) : 调用 [ViltModel](/docs/transformers/v5.23.0/zh/model_doc/vilt#transformers.ViltModel) 时传入的各模态的词汇表大小。此参数用于在拼接文本和图像模态的嵌入之后。
max_position_embeddings (`int`,*可选*,默认为 `40`):该模型可能使用的最大序列长度。
hidden_size (`int`,*可选*,默认为 `768`):隐藏表示的维度。
num_hidden_layers (`int`,*可选*,默认为 `12`):Transformer 解码器中的隐藏层数。
num_attention_heads (`int`,*可选*,默认为 `12`):Transformer 解码器中每个注意力层的注意力头数量。
intermediate_size (`int`,*可选*,默认值为 `3072`):MLP 表示的维度。
hidden_act (`str`,*可选*,默认为 `gelu`):解码器中的非线性激活函数(函数或字符串)。例如,`"gelu"`、`"relu"`、`"silu"` 等。
hidden_dropout_prob (`Union[float, int]`,*可选*,默认值为 `0.0`):嵌入层、编码器和池化器中所有全连接层的 dropout 概率。
attention_probs_dropout_prob (`Union[float, int]`,*可选*,默认值为 `0.0`):注意力概率的 dropout 比率。
initializer_range (`float`,*可选*,默认值为 `0.02`):用于初始化所有权重矩阵的 truncated_normal_initializer 的标准差。
layer_norm_eps (`float`, *可选*,默认为 `1e-12`):层归一化层所使用的 epsilon。
image_size (`Union[int, list[int], tuple[int, int]]`,*可选*,默认为 `384`):每张图片的尺寸(分辨率)。
patch_size (`Union[int, list[int], tuple[int, int]]`,*可选*,默认为 `32`):每个 patch 的大小(分辨率)。
num_channels (`int`,*可选*,默认为 `3`):输入通道数。
qkv_bias (`bool`,*可选*,默认为 `True`):是否向查询、键和值添加偏置。
max_image_length (`int`, *可选*,默认为 -1):作为 Transformer 编码器输入的最大 patch 数量。如果设置为正整数,编码器最多将采样 `max_image_length` 个 patch。如果设置为 -1,则不会考虑该参数。
tie_word_embeddings (`bool`,*可选*,默认为 `True`):是否根据模型的 `tied_weights_keys` 映射来绑定权重嵌入。
num_images (`int`,*可选*,默认为 -1):用于自然语言视觉推理的图像数量。如果设置为正整数,则会被 [ViltForImagesAndTextClassification](/docs/transformers/v5.23.0/zh/model_doc/vilt#transformers.ViltForImagesAndTextClassification) 用于定义分类器头。
pad_token_id (`int`, *可选*) : 词表中用于填充的 Token id。
这是用于存储 ViltModel 配置的类。它根据指定的参数实例化 Vilt 模型,并定义模型架构。使用默认值实例化配置将生成与 [dandelin/vilt-b32-mlm](https://huggingface.co/dandelin/vilt-b32-mlm) 类似的配置。
配置对象继承自 [PreTrainedConfig](/docs/transformers/v5.23.0/zh/main_classes/configuration#transformers.PreTrainedConfig),可用于控制模型输出。有关更多信息,请参阅 [PreTrainedConfig](/docs/transformers/v5.23.0/zh/main_classes/configuration#transformers.PreTrainedConfig) 的文档。
示例:
```python
>>> from transformers import ViLTModel, ViLTConfig
>>> # Initializing a ViLT dandelin/vilt-b32-mlm style configuration
>>> configuration = ViLTConfig()
>>> # Initializing a model from the dandelin/vilt-b32-mlm style configuration
>>> model = ViLTModel(configuration)
>>> # Accessing the model configuration
>>> configuration = model.config
```
## ViltImageProcessor[[transformers.ViltImageProcessor]]
#### transformers.ViltImageProcessor[[transformers.ViltImageProcessor]]
```python
transformers.ViltImageProcessor(**kwargs: *)
```
[来源](https://github.com/huggingface/transformers/blob/v5.23.0/src/transformers/models/vilt/image_processing_vilt.py#L52)
**参数:**
do_convert_rgb (`bool`, *kwargs*, *可选*) : 是否将图像转换为 RGB。
do_resize (`bool`, *kwargs*, *可选*, 默认为 `True`) : 是否调整图像大小。
size (`Annotated[int | list[int] | tuple[int, ...] | dict[str, int] | None, None]`, *kwargs*,默认为 `{'shortest_edge' : 384}`):描述输入到模型的最大尺寸。
default_to_square (`bool`, *kwargs*, *可选*,默认为 `False`) : 当 size 为整数时,是否在调整大小时默认使用正方形图像。
crop_size (`Annotated[int | list[int] | tuple[int, ...] | dict[str, int] | None, None]`, *kwargs*) : 应用 `center_crop` 后输出图像的尺寸。
resample (`Annotated[Union[int, PILImageResampling, NoneType], None]`, *kwargs*,默认值为 `3`) : 如果调整图像大小,则使用的重采样滤波器。它可以是枚举 `PILImageResampling` 中的一个值。仅当 `do_resize` 设置为 `True` 时才会生效。
do_rescale (`bool`, *kwargs*, *可选*,默认为 `True`):是否对图像进行重新缩放。
rescale_factor (`float`, *kwargs*, *可选*,默认为 `0.00392156862745098`) : 当 `do_rescale` 设置为 `True` 时,用于对图像进行缩放的缩放因子。
do_normalize (`bool`,*kwargs*,*可选*,默认为 `True`):是否对图像进行归一化。
image_mean (`Union[float, list[float], tuple[float, ...]]`,*kwargs*,*可选*,默认为 `[0.5, 0.5, 0.5]`):用于归一化的图像均值。仅当 `do_normalize` 设置为 `True` 时生效。
image_std (`Union[float, list[float], tuple[float, ...]]`, *kwargs*, *可选*,默认为 `[0.5, 0.5, 0.5]`) : 用于归一化的图像标准差。仅当 `do_normalize` 设置为 `True` 时生效。
do_pad (`bool`, *kwargs*, *可选*,默认为 `True`) : 是否对图像进行填充。填充操作会将图像填充至批次中的最大尺寸,或填充至每张图像的固定正方形尺寸。具体的填充策略取决于模型。
pad_size (`Annotated[int | list[int] | tuple[int, ...] | dict[str, int] | None, None]`, *kwargs*) : 用于将图像填充到的尺寸,格式为 `{"height": int, "width" int}`。该尺寸必须大于预处理中提供的任何图像尺寸。如果未提供 `pad_size`,图像将被填充到批次中最大的高度和宽度。仅在 `do_pad=True.` 时应用。
do_center_crop (`bool`, *kwargs*, *可选*) : 是否对图像进行居中裁剪。
data_format (`Union[str, ~image_utils.ChannelDimension]`,*kwargs*,*可选*):仅支持 `ChannelDimension.FIRST`。为兼容旧版处理器而添加。
input_data_format (`Union[str, ~image_utils.ChannelDimension]`, *kwargs*, *可选*) : 输入图像的通道维度格式。如果未设置,则从输入图像中推断通道维度格式。可以是以下之一: - `"channels_first"` 或 `ChannelDimension.FIRST`:图像为 (num_channels, height, width) 格式。 - `"channels_last"` 或 `ChannelDimension.LAST`:图像为 (height, width, num_channels) 格式。 - `"none"` 或 `ChannelDimension.NONE`:图像为 (height, width) 格式。
device (`Annotated[Union[str, torch.device, NoneType], None]`, *kwargs*):用于处理视频的设备。如果未设置,则从输入视频中推断设备。
return_tensors (`Annotated[str | ~utils.generic.TensorType | None, None]`, *kwargs*) : 如果设置为 `'pt'`,则返回堆叠的张量,否则返回张量列表。
disable_grouping (`bool`, *kwargs*, *可选*) : 是否禁用按尺寸对图像进行分组,从而逐个处理图像而非批量处理。如果为 None,则当图像位于 CPU 上时设置为 True,否则设置为 False。此选择基于经验观察,详见此处:https://github.com/huggingface/transformers/pull/38157
image_seq_length (`int`, *kwargs*, *可选*) : 输入中每张图片所使用的图像标记数量。为向后兼容而添加,但在未来的模型中应将其设置为处理器属性。如果设置为 `'pt'`,则返回堆叠的张量,否则返回张量列表。
disable_grouping (`bool`, *kwargs*, *可选*) : 是否禁用按尺寸对图像进行分组,从而逐个处理图像而非批量处理。如果为 None,则当图像位于 CPU 上时设置为 True,否则设置为 False。此选择基于经验观察,详见此处:https://github.com/huggingface/transformers/pull/38157
image_seq_length (`int`, *kwargs*, *可选*) : 输入中每张图片所使用的图像标记数量。为向后兼容而添加,但在未来的模型中应将其设置为处理器属性。如果设置为 `'pt'`,则返回堆叠的张量,否则返回张量列表。
disable_grouping (`bool`, *kwargs*, *可选*) : 是否禁用按尺寸对图像进行分组,从而逐个处理图像而非批量处理。如果为 None,则当图像位于 CPU 上时设置为 True,否则设置为 False。此选择基于经验观察,详见此处:https://github.com/huggingface/transformers/pull/38157
image_seq_length (`int`, *kwargs*, *可选*) : 输入中每张图片所使用的图像标记数量。为向后兼容而添加,但在未来的模型中应将其设置为处理器属性。如果设置为 `'pt'`,则返回堆叠的张量,否则返回张量列表。
disable_grouping (`bool`, *kwargs*, *可选*) : 是否禁用按尺寸对图像进行分组,从而逐个处理图像而非批量处理。如果为 None,则当图像位于 CPU 上时设置为 True,否则设置为 False。此选择基于经验观察,详见此处:https://github.com/huggingface/transformers/pull/38157
image_seq_length (`int`, *kwargs*, *可选*) : 输入中每张图片所使用的图像标记数量。为向后兼容而添加,但在未来的模型中应将其设置为处理器属性。如果设置为 `'pt'`,则返回堆叠的张量,否则返回张量列表。
disable_grouping (`bool`, *kwargs*, *可选*) : 是否禁用按尺寸对图像进行分组,从而逐个处理图像而非批量处理。如果为 None,则当图像位于 CPU 上时设置为 True,否则设置为 False。此选择基于经验观察,详见此处:https://github.com/huggingface/transformers/pull/38157
image_seq_length (`int`, *kwargs*, *可选*) : 输入中每张图片所使用的图像 token 数量。为向后兼容而添加,但在未来的模型中,应将其设置为处理器的属性。
如果设置为 `'pt'`,则返回堆叠的张量,否则返回张量列表。 --
构建一个 ViltImageProcessor 图像处理器。
disable_grouping (`bool`, *kwargs*, *可选*):是否禁用按大小对图像进行分组,以便单独处理图像而不是批量处理。如果为 None,则当图像位于 CPU 上时设置为 True,否则设置为 False。此选择基于经验观察,详情见此处:https://github.com/huggingface/transformers/pull/38157 image_seq_length (`int`, *kwargs*, *可选*):输入中每张图像要使用的图像标记数量。为向后兼容而添加,但在未来的模型中应将其设置为处理器的属性。
#### preprocess[[transformers.ViltImageProcessor.preprocess]]
```python
preprocess(images: typing.Union[ForwardRef('PIL.Image.Image'), numpy.ndarray, ForwardRef('torch.Tensor'), list['PIL.Image.Image'], list[numpy.ndarray], list['torch.Tensor']], *args, image_like_kwargs: dict[str, typing.Any] | None = None, **kwargs: *)
```
[来源](https://github.com/huggingface/transformers/blob/v5.23.0/src/transformers/image_processing_utils.py#L382)
**参数:**
images (`Union[PIL.Image.Image, numpy.ndarray, torch.Tensor, list[PIL.Image.Image], list[numpy.ndarray], list[torch.Tensor]]`) : 要预处理的图像。期望输入单张或一批像素值在 0 到 255 之间的图像。如果传入的图像像素值在 0 到 1 之间,请设置 `do_rescale=False`。
image_like_kwargs (`dict[str, Any]`,*可选*):用于额外图像类输入的开发者标志,这些输入也将被预处理。仅在以关键字参数传递输入不起作用时使用此标志。例如,`preprocess(images, masks=masks)` 是首选方式,但对于某些模型会导致参数优先级问题。在这种情况下,可以改用 `preprocess(images, image_like_inputs={"masks": masks})`。
do_convert_rgb (`bool`, *kwargs*, *可选*) : 是否将图像转换为 RGB。
do_resize (`bool`,*kwargs*,*可选*):是否调整图像大小。
size (`Annotated[int | list[int] | tuple[int, ...] | dict[str, int] | None, None]`, *kwargs*):描述模型的最大输入维度。
default_to_square (`bool`, *kwargs*, *可选*) : 当 size 为 int 时,是否在调整大小时默认使用正方形图像。
crop_size (`Annotated[int | list[int] | tuple[int, ...] | dict[str, int] | None, None]`, *kwargs*) : 应用 `center_crop` 后输出图像的尺寸。
resample (`Annotated[Union[int, PILImageResampling, NoneType], None]`, *kwargs*) : 如果调整图像大小,则使用的重采样滤波器。它可以是枚举 `PILImageResampling` 中的一个值。仅当 `do_resize` 设置为 `True` 时才会生效。
do_rescale (`bool`, *kwargs*, *可选*) : 是否对图像进行重新缩放。
rescale_factor (`float`, *kwargs*, *可选*) : 当 `do_rescale` 设置为 `True` 时,用于对图像进行缩放的缩放因子。
do_normalize (`bool`, *kwargs*, *可选*) : 是否对图像进行归一化。
image_mean (`Union[float, list[float], tuple[float, ...]]`,*kwargs*,*可选*):用于归一化的图像均值。仅当 `do_normalize` 设置为 `True` 时生效。
image_std (`Union[float, list[float], tuple[float, ...]]`, *kwargs*, *可选*) : 用于归一化的图像标准差。仅当 `do_normalize` 设置为 `True` 时生效。
do_pad (`bool`, *kwargs*, *可选*) : 是否对图像进行填充。填充操作会将图像填充至批次中的最大尺寸,或填充至每张图像的固定正方形尺寸。具体的填充策略取决于模型。
pad_size (`Annotated[int | list[int] | tuple[int, ...] | dict[str, int] | None, None]`, *kwargs*) : 用于将图像填充到的尺寸,格式为 `{"height": int, "width" int}`。该尺寸必须大于预处理中提供的任何图像尺寸。如果未提供 `pad_size`,图像将被填充到批次中最大的高度和宽度。仅在 `do_pad=True.` 时应用。
do_center_crop (`bool`, *kwargs*, *可选*) : 是否对图像进行居中裁剪。
data_format (`Union[str, ~image_utils.ChannelDimension]`,*kwargs*,*可选*):仅支持 `ChannelDimension.FIRST`。为兼容旧版处理器而添加。
input_data_format (`Union[str, ~image_utils.ChannelDimension]`, *kwargs*, *可选*) : 输入图像的通道维度格式。如果未设置,则从输入图像中推断通道维度格式。可以是以下之一: - `"channels_first"` 或 `ChannelDimension.FIRST`:图像为 (num_channels, height, width) 格式。 - `"channels_last"` 或 `ChannelDimension.LAST`:图像为 (height, width, num_channels) 格式。 - `"none"` 或 `ChannelDimension.NONE`:图像为 (height, width) 格式。
device (`Annotated[Union[str, torch.device, NoneType], None]`, *kwargs*):用于处理视频的设备。如果未设置,则从输入视频中推断设备。
return_tensors (`Annotated[str | ~utils.generic.TensorType | None, None]`, *kwargs*) : 如果设置为 `'pt'`,则返回堆叠的张量,否则返回张量列表。
disable_grouping (`bool`, *kwargs*, *可选*) : 是否禁用按尺寸对图像进行分组,从而逐个处理图像而非批量处理。如果为 None,则当图像位于 CPU 上时设置为 True,否则设置为 False。此选择基于经验观察,详见此处:https://github.com/huggingface/transformers/pull/38157
image_seq_length (`int`, *kwargs*, *可选*) : 输入中每张图片所使用的图像 token 数量。为向后兼容而添加,但在未来的模型中,应将其设置为处理器的属性。
**返回:** `~image_processing_base.BatchFeature`
- **data** (`dict`) -- 由 __call__ 方法返回的列表/数组/张量字典(例如 'pixel_values')。
- **tensor_type** (`Union[None, str, TensorType]`,*可选*) -- 您可以在此处指定 tensor_type,以便在初始化时将 PyTorch/Numpy 张量中的整数列表进行转换。
预处理一张图像或一批图像。
## ViltImageProcessorPil[[transformers.ViltImageProcessorPil]]
#### transformers.ViltImageProcessorPil[[transformers.ViltImageProcessorPil]]
```python
transformers.ViltImageProcessorPil(**kwargs: *)
```
[来源](https://github.com/huggingface/transformers/blob/v5.23.0/src/transformers/models/vilt/image_processing_pil_vilt.py#L113)
**参数:**
do_convert_rgb (`bool`, *kwargs*, *可选*) : 是否将图像转换为 RGB。
do_resize (`bool`, *kwargs*, *可选*, 默认为 `True`) : 是否调整图像大小。
size (`Annotated[int | list[int] | tuple[int, ...] | dict[str, int] | None, None]`, *kwargs*,默认为 `{'shortest_edge' : 384}`):描述输入到模型的最大尺寸。
default_to_square (`bool`, *kwargs*, *可选*,默认为 `False`) : 当 size 为整数时,是否在调整大小时默认使用正方形图像。
crop_size (`Annotated[int | list[int] | tuple[int, ...] | dict[str, int] | None, None]`, *kwargs*) : 应用 `center_crop` 后输出图像的尺寸。
resample (`Annotated[Union[int, PILImageResampling, NoneType], None]`, *kwargs*,默认值为 `3`) : 如果调整图像大小,则使用的重采样滤波器。它可以是枚举 `PILImageResampling` 中的一个值。仅当 `do_resize` 设置为 `True` 时才会生效。
do_rescale (`bool`, *kwargs*, *可选*,默认为 `True`):是否对图像进行重新缩放。
rescale_factor (`float`, *kwargs*, *可选*,默认为 `0.00392156862745098`) : 当 `do_rescale` 设置为 `True` 时,用于对图像进行缩放的缩放因子。
do_normalize (`bool`,*kwargs*,*可选*,默认为 `True`):是否对图像进行归一化。
image_mean (`Union[float, list[float], tuple[float, ...]]`,*kwargs*,*可选*,默认为 `[0.5, 0.5, 0.5]`):用于归一化的图像均值。仅当 `do_normalize` 设置为 `True` 时生效。
image_std (`Union[float, list[float], tuple[float, ...]]`, *kwargs*, *可选*,默认为 `[0.5, 0.5, 0.5]`) : 用于归一化的图像标准差。仅当 `do_normalize` 设置为 `True` 时生效。
do_pad (`bool`, *kwargs*, *可选*,默认为 `True`) : 是否对图像进行填充。填充操作会将图像填充至批次中的最大尺寸,或填充至每张图像的固定正方形尺寸。具体的填充策略取决于模型。
pad_size (`Annotated[int | list[int] | tuple[int, ...] | dict[str, int] | None, None]`, *kwargs*) : 用于将图像填充到的尺寸,格式为 `{"height": int, "width" int}`。该尺寸必须大于预处理中提供的任何图像尺寸。如果未提供 `pad_size`,图像将被填充到批次中最大的高度和宽度。仅在 `do_pad=True.` 时应用。
do_center_crop (`bool`, *kwargs*, *可选*) : 是否对图像进行居中裁剪。
data_format (`Union[str, ~image_utils.ChannelDimension]`,*kwargs*,*可选*):仅支持 `ChannelDimension.FIRST`。为兼容旧版处理器而添加。
input_data_format (`Union[str, ~image_utils.ChannelDimension]`, *kwargs*, *可选*) : 输入图像的通道维度格式。如果未设置,则从输入图像中推断通道维度格式。可以是以下之一: - `"channels_first"` 或 `ChannelDimension.FIRST`:图像为 (num_channels, height, width) 格式。 - `"channels_last"` 或 `ChannelDimension.LAST`:图像为 (height, width, num_channels) 格式。 - `"none"` 或 `ChannelDimension.NONE`:图像为 (height, width) 格式。
device (`Annotated[Union[str, torch.device, NoneType], None]`, *kwargs*):用于处理视频的设备。如果未设置,则从输入视频中推断设备。
return_tensors (`Annotated[str | ~utils.generic.TensorType | None, None]`, *kwargs*) : 如果设置为 `'pt'`,则返回堆叠的张量,否则返回张量列表。
disable_grouping (`bool`, *kwargs*, *可选*) : 是否禁用按尺寸对图像进行分组,从而逐个处理图像而非批量处理。如果为 None,则当图像位于 CPU 上时设置为 True,否则设置为 False。此选择基于经验观察,详见此处:https://github.com/huggingface/transformers/pull/38157
image_seq_length (`int`, *kwargs*, *可选*) : 输入中每张图片所使用的图像 token 数量。为向后兼容而添加,但在未来的模型中,应将其设置为处理器的属性。
如果设置为 `'pt'`,则返回堆叠的张量,否则返回张量列表。 --
构建一个 ViltImageProcessor 图像处理器。
disable_grouping (`bool`, *kwargs*, *可选*):是否禁用按大小对图像进行分组,以便单独处理图像而不是批量处理。如果为 None,则当图像位于 CPU 上时设置为 True,否则设置为 False。此选择基于经验观察,详情见此处:https://github.com/huggingface/transformers/pull/38157 image_seq_length (`int`, *kwargs*, *可选*):输入中每张图像要使用的图像标记数量。为向后兼容而添加,但在未来的模型中应将其设置为处理器的属性。
#### preprocess[[transformers.ViltImageProcessorPil.preprocess]]
```python
preprocess(images: typing.Union[ForwardRef('PIL.Image.Image'), numpy.ndarray, ForwardRef('torch.Tensor'), list['PIL.Image.Image'], list[numpy.ndarray], list['torch.Tensor']], *args, image_like_kwargs: dict[str, typing.Any] | None = None, **kwargs: *)
```
[来源](https://github.com/huggingface/transformers/blob/v5.23.0/src/transformers/image_processing_utils.py#L382)
**参数:**
images (`Union[PIL.Image.Image, numpy.ndarray, torch.Tensor, list[PIL.Image.Image], list[numpy.ndarray], list[torch.Tensor]]`) : 要预处理的图像。期望输入单张或一批像素值在 0 到 255 之间的图像。如果传入的图像像素值在 0 到 1 之间,请设置 `do_rescale=False`。
image_like_kwargs (`dict[str, Any]`,*可选*):用于额外图像类输入的开发者标志,这些输入也将被预处理。仅在以关键字参数传递输入不起作用时使用此标志。例如,`preprocess(images, masks=masks)` 是首选方式,但对于某些模型会导致参数优先级问题。在这种情况下,可以改用 `preprocess(images, image_like_inputs={"masks": masks})`。
do_convert_rgb (`bool`, *kwargs*, *可选*) : 是否将图像转换为 RGB。
do_resize (`bool`,*kwargs*,*可选*):是否调整图像大小。
size (`Annotated[int | list[int] | tuple[int, ...] | dict[str, int] | None, None]`, *kwargs*):描述模型的最大输入维度。
default_to_square (`bool`, *kwargs*, *可选*) : 当 size 为 int 时,是否在调整大小时默认使用正方形图像。
crop_size (`Annotated[int | list[int] | tuple[int, ...] | dict[str, int] | None, None]`, *kwargs*) : 应用 `center_crop` 后输出图像的尺寸。
resample (`Annotated[Union[int, PILImageResampling, NoneType], None]`, *kwargs*) : 如果调整图像大小,则使用的重采样滤波器。它可以是枚举 `PILImageResampling` 中的一个值。仅当 `do_resize` 设置为 `True` 时才会生效。
do_rescale (`bool`, *kwargs*, *可选*) : 是否对图像进行重新缩放。
rescale_factor (`float`, *kwargs*, *可选*) : 当 `do_rescale` 设置为 `True` 时,用于对图像进行缩放的缩放因子。
do_normalize (`bool`, *kwargs*, *可选*) : 是否对图像进行归一化。
image_mean (`Union[float, list[float], tuple[float, ...]]`,*kwargs*,*可选*):用于归一化的图像均值。仅当 `do_normalize` 设置为 `True` 时生效。
image_std (`Union[float, list[float], tuple[float, ...]]`, *kwargs*, *可选*) : 用于归一化的图像标准差。仅当 `do_normalize` 设置为 `True` 时生效。
do_pad (`bool`, *kwargs*, *可选*) : 是否对图像进行填充。填充操作会将图像填充至批次中的最大尺寸,或填充至每张图像的固定正方形尺寸。具体的填充策略取决于模型。
pad_size (`Annotated[int | list[int] | tuple[int, ...] | dict[str, int] | None, None]`, *kwargs*) : 用于将图像填充到的尺寸,格式为 `{"height": int, "width" int}`。该尺寸必须大于预处理中提供的任何图像尺寸。如果未提供 `pad_size`,图像将被填充到批次中最大的高度和宽度。仅在 `do_pad=True.` 时应用。
do_center_crop (`bool`, *kwargs*, *可选*) : 是否对图像进行居中裁剪。
data_format (`Union[str, ~image_utils.ChannelDimension]`,*kwargs*,*可选*):仅支持 `ChannelDimension.FIRST`。为兼容旧版处理器而添加。
input_data_format (`Union[str, ~image_utils.ChannelDimension]`, *kwargs*, *可选*) : 输入图像的通道维度格式。如果未设置,则从输入图像中推断通道维度格式。可以是以下之一: - `"channels_first"` 或 `ChannelDimension.FIRST`:图像为 (num_channels, height, width) 格式。 - `"channels_last"` 或 `ChannelDimension.LAST`:图像为 (height, width, num_channels) 格式。 - `"none"` 或 `ChannelDimension.NONE`:图像为 (height, width) 格式。
device (`Annotated[Union[str, torch.device, NoneType], None]`, *kwargs*):用于处理视频的设备。如果未设置,则从输入视频中推断设备。
return_tensors (`Annotated[str | ~utils.generic.TensorType | None, None]`, *kwargs*) : 如果设置为 `'pt'`,则返回堆叠的张量,否则返回张量列表。
disable_grouping (`bool`, *kwargs*, *可选*) : 是否禁用按尺寸对图像进行分组,从而逐个处理图像而非批量处理。如果为 None,则当图像位于 CPU 上时设置为 True,否则设置为 False。此选择基于经验观察,详见此处:https://github.com/huggingface/transformers/pull/38157
image_seq_length (`int`, *kwargs*, *可选*) : 输入中每张图片所使用的图像 token 数量。为向后兼容而添加,但在未来的模型中,应将其设置为处理器的属性。
**返回:** `~image_processing_base.BatchFeature`
- **data** (`dict`) -- 由 __call__ 方法返回的列表/数组/张量字典(例如 'pixel_values')。
- **tensor_type** (`Union[None, str, TensorType]`,*可选*) -- 您可以在此处指定 tensor_type,以便在初始化时将 PyTorch/Numpy 张量中的整数列表进行转换。
预处理一张图像或一批图像。
## ViltProcessor[[transformers.ViltProcessor]]
#### transformers.ViltProcessor[[transformers.ViltProcessor]]
```python
transformers.ViltProcessor(image_processor = None, tokenizer = None, **kwargs)
```
[来源](https://github.com/huggingface/transformers/blob/v5.23.0/src/transformers/models/vilt/processing_vilt.py#L24)
**参数:**
image_processor (`ViltImageProcessor`):图像处理器是必需的输入。
tokenizer (`BertTokenizer`):分词器是必需的输入。
构建一个 ViltProcessor,它将图像处理器和分词器封装为单个处理器。
[ViltProcessor](/docs/transformers/v5.23.0/zh/model_doc/vilt#transformers.ViltProcessor) 提供了 [ViltImageProcessor](/docs/transformers/v5.23.0/zh/model_doc/vilt#transformers.ViltImageProcessor) 和 [BertTokenizer](/docs/transformers/v5.23.0/zh/model_doc/lxmert#transformers.BertTokenizer) 的所有功能。有关更多信息,请参阅 [~ViltImageProcessor](/docs/transformers/v5.23.0/zh/model_doc/vilt#transformers.ViltImageProcessor) 和 [~BertTokenizer](/docs/transformers/v5.23.0/zh/model_doc/lxmert#transformers.BertTokenizer)。
#### __调用__[[transformers.ViltProcessor.__call__]]
```python
__call__(images: typing.Union[ForwardRef('PIL.Image.Image'), numpy.ndarray, ForwardRef('torch.Tensor'), list['PIL.Image.Image'], list[numpy.ndarray], list['torch.Tensor'], NoneType] = None, text: str | list[str] | list[list[str]] | None = None, videos: typing.Union[list['PIL.Image.Image'], numpy.ndarray, ForwardRef('torch.Tensor'), list[numpy.ndarray], list['torch.Tensor'], list[list['PIL.Image.Image']], list[list[numpy.ndarray]], list[list['torch.Tensor']], transformers.video_utils.URL, list[transformers.video_utils.URL], list[list[transformers.video_utils.URL]], transformers.video_utils.Path, list[transformers.video_utils.Path], list[list[transformers.video_utils.Path]], NoneType] = None, audio: typing.Union[numpy.ndarray, ForwardRef('torch.Tensor'), collections.abc.Sequence[numpy.ndarray], collections.abc.Sequence['torch.Tensor'], NoneType] = None, **kwargs: *)
```
[来源](https://github.com/huggingface/transformers/blob/v5.23.0/src/transformers/processing_utils.py#L670)
**参数:**
images (`Union[PIL.Image.Image, numpy.ndarray, torch.Tensor, list[PIL.Image.Image], list[numpy.ndarray], list[torch.Tensor]]`, *可选*) : 要预处理的图像。期望输入单张图像或一批图像,其像素值范围为 0 到 255。如果传入的图像像素值在 0 到 1 之间,请设置 `do_rescale=False`。
text (`Union[str, list[str], list[list[str]]]`,*可选*):要编码的序列或序列批次。每个序列可以是字符串或字符串列表(预分词字符串)。如果传入预分词输入,请设置 `is_split_into_words=True` 以避免与批量输入产生歧义。
videos (`Union[list[PIL.Image.Image], numpy.ndarray, torch.Tensor, list[numpy.ndarray], list[torch.Tensor], list[list[PIL.Image.Image]], list[list[numpy.ndarray]], list[list[torch.Tensor]], ~video_utils.URL, list[~video_utils.URL], list[list[~video_utils.URL]], ~video_utils.Path, list[~video_utils.Path], list[list[~video_utils.Path]]]`,*可选*):要预处理的视频。期望输入单个视频或一批视频,其像素值范围为 0 到 255。如果传入的像素值在 0 到 1 之间,请设置 `do_rescale=False`。
audio (`Union[numpy.ndarray, torch.Tensor, collections.abc.Sequence[numpy.ndarray], collections.abc.Sequence[torch.Tensor]]`,*可选*):要准备处理的音频或音频批次。每个音频可以是 NumPy 数组或 PyTorch 张量。对于 NumPy 数组/PyTorch 张量,每个音频的形状应为 (C, T),其中 C 是通道数,T 是音频的采样长度。
return_mm_token_type_ids (`bool`, *kwargs*) : 是否返回多模态 token 类型 ID,以指示多模态占位符 token 的位置。
return_text_replacement_offsets (`bool`, *kwargs*) : 是否返回每个多模态占位符及其替换项的字符偏移量。
return_tensors (`str` 或 [TensorType](/docs/transformers/v5.23.0/zh/internal/file_utils#transformers.TensorType),*可选*):如果设置,将返回特定框架的张量。可接受的值为: - `'pt'`:返回 PyTorch `torch.Tensor` 对象。 - `'np'`:返回 NumPy `np.ndarray` 对象。
- ****kwargs** ([ProcessingKwargs](/docs/transformers/v5.23.0/zh/main_classes/processors#transformers.ProcessingKwargs), *可选*) : 针对每种模态(文本、图像、视频、音频)的额外处理选项。模型特定参数已在上方列出;有关支持参数的完整列表,请参阅 TypedDict 类。
## ViltModel[[transformers.ViltModel]]
#### transformers.ViltModel[[transformers.ViltModel]]
```python
transformers.ViltModel(config: ViltConfig, add_pooling_layer = True)
```
[来源](https://github.com/huggingface/transformers/blob/v5.23.0/src/transformers/models/vilt/modeling_vilt.py#L511)
**参数:**
config ([ViltConfig](/docs/transformers/v5.23.0/zh/model_doc/vilt#transformers.ViltConfig)):模型配置类,包含模型的所有参数。使用配置文件进行初始化并不会加载与模型关联的权重,仅加载配置。请查看 [from_pretrained()](/docs/transformers/v5.23.0/zh/main_classes/model#transformers.PreTrainedModel.from_pretrained) 方法以加载模型权重。
add_pooling_layer (`bool`,*可选*,默认为 `True`):是否添加池化层
原始的 Vilt 模型,输出原始隐藏状态,顶部未添加任何特定头。
该模型继承自 [PreTrainedModel](/docs/transformers/v5.23.0/zh/main_classes/model#transformers.PreTrainedModel)。请查阅父类文档,了解该库为所有模型实现的通用方法(例如下载或保存、调整输入嵌入大小、剪枝头等)。
该模型也是 PyTorch [torch.nn.Module](https://pytorch.org/docs/stable/nn.html#torch.nn.Module) 的子类。请将其作为常规的 PyTorch Module 使用,有关通用用法和行为的所有事项,请参阅 PyTorch 文档。
#### forward[[transformers.ViltModel.forward]]
```python
forward(input_ids: typing.Optional[torch.LongTensor] = None, attention_mask: typing.Optional[torch.Tensor] = None, token_type_ids: typing.Optional[torch.LongTensor] = None, pixel_values: typing.Optional[torch.Tensor] = None, pixel_mask: typing.Optional[torch.LongTensor] = None, inputs_embeds: typing.Optional[torch.Tensor] = None, image_embeds: typing.Optional[torch.Tensor] = None, image_token_type_idx: int | None = None, output_attentions: bool | None = None, output_hidden_states: bool | None = None, return_dict: bool | None = None, **kwargs)
```
[来源](https://github.com/huggingface/transformers/blob/v5.23.0/src/transformers/models/vilt/modeling_vilt.py#L535)
**参数:**
input_ids (`torch.LongTensor`,形状为 `(batch_size, sequence_length)`,*可选*):输入序列中 token 在词汇表中的索引。默认情况下,填充(padding)将被忽略。可以使用 [AutoTokenizer](/docs/transformers/v5.23.0/zh/model_doc/auto#transformers.AutoTokenizer) 获取索引。有关详细信息,请参阅 [PreTrainedTokenizer.encode()](/docs/transformers/v5.23.0/zh/internal/tokenization_utils#transformers.PreTrainedTokenizerBase.encode) 和 [PreTrainedTokenizer.__call__()](/docs/transformers/v5.23.0/zh/internal/tokenization_utils#transformers.PreTrainedTokenizerBase.__call__)。[什么是输入 ID?](../glossary#input-ids)
attention_mask (`torch.Tensor`,形状为 `(batch_size, sequence_length)`,*可选*):用于避免对填充(padding)标记索引执行注意力机制的掩码。掩码值取自 `[0, 1]`: - 1 表示**未掩码**的标记, - 0 表示**已掩码**的标记。 [什么是注意力掩码?](../glossary#attention-mask)
token_type_ids (`torch.LongTensor`,形状为 `(batch_size, sequence_length)`,*可选*):用于指示输入中第一和第二部分的段标记索引。索引选自 `[0, 1]`: - 0 对应 *句子 A* 的标记, - 1 对应 *句子 B* 的标记。 [什么是标记类型 ID?](../glossary#token-type-ids)
pixel_values (`torch.Tensor`,形状为 `(batch_size, num_channels, image_size, image_size)`,*可选*) : 与输入图像对应的张量。可以使用 [ViltImageProcessor](/docs/transformers/v5.23.0/zh/model_doc/vilt#transformers.ViltImageProcessor) 获取像素值。有关详细信息,请参阅 [ViltImageProcessor.__call__()](/docs/transformers/v5.23.0/zh/model_doc/molmo2#transformers.Molmo2ImageProcessor.__call__)([ViltProcessor](/docs/transformers/v5.23.0/zh/model_doc/vilt#transformers.ViltProcessor) 使用 [ViltImageProcessor](/docs/transformers/v5.23.0/zh/model_doc/vilt#transformers.ViltImageProcessor) 处理图像)。
pixel_mask (`torch.LongTensor`,形状为 `(batch_size, height, width)`,*可选*):用于避免对填充像素值执行注意力的掩码。掩码值取自 `[0, 1]`: - 1 表示真实像素(即 **未掩码**), - 0 表示填充像素(即 **已掩码**)。 [什么是注意力掩码?](../glossary#attention-mask)
inputs_embeds (`torch.Tensor`,形状为 `(batch_size, sequence_length, hidden_size)`,*可选*):可选地,你可以选择直接传入嵌入表示,而不是传入 `input_ids`。如果你希望比模型内部的嵌入查找矩阵更精细地控制如何将 `input_ids` 索引转换为对应的向量,这将非常有用。
image_embeds (`torch.Tensor`,形状为 `(batch_size, num_patches, hidden_size)`,*可选*):可选地,你可以选择直接传入嵌入表示,而不是传入 `pixel_values`。如果你希望更精细地控制如何将 `pixel_values` 转换为补丁嵌入,这将非常有用。
image_token_type_idx (`int`, *可选*) : - 图像的 token 类型 ID。
output_attentions (`bool`, *可选*) : 是否返回所有注意力层的注意力张量。有关更多详细信息,请参阅返回张量中的 `attentions`。
output_hidden_states (`bool`, *可选*) : 是否返回所有层的隐藏状态。有关更多详细信息,请参阅返回张量中的 `hidden_states`。
return_dict (`bool`, *可选*) : 是否返回 [ModelOutput](/docs/transformers/v5.23.0/zh/main_classes/output#transformers.utils.ModelOutput) 而不是普通元组。
**返回:** [BaseModelOutputWithPooling](/docs/transformers/v5.23.0/zh/main_classes/output#transformers.modeling_outputs.BaseModelOutputWithPooling) 或 `tuple(torch.Tensor)`
一个 [BaseModelOutputWithPooling](/docs/transformers/v5.23.0/zh/main_classes/output#transformers.modeling_outputs.BaseModelOutputWithPooling) 或 `torch.Tensor` 元组(如果传入了 `return_dict=False` 或 `config.return_dict=False`),其包含的元素取决于配置([ViltConfig](/docs/transformers/v5.23.0/zh/model_doc/vilt#transformers.ViltConfig))和输入。
[ViltModel](/docs/transformers/v5.23.0/zh/model_doc/vilt#transformers.ViltModel) 的 forward 方法重写了 `__call__` 特殊方法。
尽管前向传播的实现需要在此函数中定义,但之后应调用 `Module` 实例,而不是直接调用此函数,因为前者会负责执行预处理和后处理步骤,而后者会静默地忽略这些步骤。
- **last_hidden_state**(形状为 `(batch_size, sequence_length, hidden_size)` 的 `torch.Tensor`)-- 模型最后一层输出的隐藏状态序列。
- **pooler_output**(形状为 `(batch_size, hidden_size)` 的 `torch.Tensor`)-- 序列中第一个 token(分类 token)的最后一层隐藏状态,经过用于辅助预训练任务的层进一步处理后的结果。例如,对于 BERT 系列模型,这返回的是分类 token 经过线性层和 tanh 激活函数处理后的结果。线性层的权重是在预训练期间通过下一句预测(分类)目标训练得到的。
- **hidden_states** (`tuple(torch.Tensor)`,*可选*,在传入 `output_hidden_states=True` 或 `config.output_hidden_states=True` 时返回) -- 一个 `torch.Tensor` 元组(如果模型具有嵌入层,则包含嵌入层的输出,以及每一层的输出),形状为 `(batch_size, sequence_length, hidden_size)`。
模型在每一层输出处的隐藏状态,以及可选的初始嵌入输出。
- **attentions** (`tuple(torch.Tensor)`,*可选*,当传入 `output_attentions=True` 或 `config.output_attentions=True` 时返回) -- 一个 `torch.Tensor` 元组(每层一个),形状为 `(batch_size, num_heads, sequence_length, sequence_length)`。
经过注意力 softmax 后的注意力权重,用于在自注意力头中计算加权平均值。
示例:
```python
>>> from transformers import ViltProcessor, ViltModel
>>> from PIL import Image
>>> from huggingface_hub.utils import httpx
>>> from io import BytesIO
>>> # prepare image and text
>>> url = "http://images.cocodataset.org/val2017/000000039769.jpg"
>>> with httpx.stream("GET", url) as response:
... image = Image.open(BytesIO(response.read()))
>>> text = "hello world"
>>> processor = ViltProcessor.from_pretrained("dandelin/vilt-b32-mlm")
>>> model = ViltModel.from_pretrained("dandelin/vilt-b32-mlm")
>>> inputs = processor(image, text, return_tensors="pt")
>>> outputs = model(**inputs)
>>> last_hidden_states = outputs.last_hidden_state
```
## ViltForMaskedLM[[transformers.ViltForMaskedLM]]
#### transformers.ViltForMaskedLM[[transformers.ViltForMaskedLM]]
```python
transformers.ViltForMaskedLM(config: ViltConfig)
```
[来源](https://github.com/huggingface/transformers/blob/v5.23.0/src/transformers/models/vilt/modeling_vilt.py#L671)
**参数:**
config ([ViltConfig](/docs/transformers/v5.23.0/zh/model_doc/vilt#transformers.ViltConfig)):模型配置类,包含模型的所有参数。使用配置文件进行初始化并不会加载与模型关联的权重,仅加载配置。请查看 [from_pretrained()](/docs/transformers/v5.23.0/zh/main_classes/model#transformers.PreTrainedModel.from_pretrained) 方法以加载模型权重。
在预训练过程中,在 ViLT 模型顶部添加语言建模头。
该模型继承自 [PreTrainedModel](/docs/transformers/v5.23.0/zh/main_classes/model#transformers.PreTrainedModel)。请查阅父类文档,了解该库为所有模型实现的通用方法(例如下载或保存、调整输入嵌入大小、剪枝头等)。
该模型也是 PyTorch [torch.nn.Module](https://pytorch.org/docs/stable/nn.html#torch.nn.Module) 的子类。请将其作为常规的 PyTorch Module 使用,有关通用用法和行为的所有事项,请参阅 PyTorch 文档。
#### forward[[transformers.ViltForMaskedLM.forward]]
```python
forward(input_ids: typing.Optional[torch.LongTensor] = None, attention_mask: typing.Optional[torch.Tensor] = None, token_type_ids: typing.Optional[torch.LongTensor] = None, pixel_values: typing.Optional[torch.Tensor] = None, pixel_mask: typing.Optional[torch.LongTensor] = None, inputs_embeds: typing.Optional[torch.Tensor] = None, image_embeds: typing.Optional[torch.Tensor] = None, labels: typing.Optional[torch.LongTensor] = None, output_attentions: bool | None = None, output_hidden_states: bool | None = None, return_dict: bool | None = None, **kwargs)
```
[来源](https://github.com/huggingface/transformers/blob/v5.23.0/src/transformers/models/vilt/modeling_vilt.py#L692)
**参数:**
input_ids (`torch.LongTensor`,形状为 `(batch_size, sequence_length)`,*可选*):输入序列中 token 在词汇表中的索引。默认情况下,填充(padding)将被忽略。可以使用 [AutoTokenizer](/docs/transformers/v5.23.0/zh/model_doc/auto#transformers.AutoTokenizer) 获取索引。有关详细信息,请参阅 [PreTrainedTokenizer.encode()](/docs/transformers/v5.23.0/zh/internal/tokenization_utils#transformers.PreTrainedTokenizerBase.encode) 和 [PreTrainedTokenizer.__call__()](/docs/transformers/v5.23.0/zh/internal/tokenization_utils#transformers.PreTrainedTokenizerBase.__call__)。[什么是输入 ID?](../glossary#input-ids)
attention_mask (`torch.Tensor`,形状为 `(batch_size, sequence_length)`,*可选*):用于避免对填充(padding)标记索引执行注意力机制的掩码。掩码值取自 `[0, 1]`: - 1 表示**未掩码**的标记, - 0 表示**已掩码**的标记。 [什么是注意力掩码?](../glossary#attention-mask)
token_type_ids (`torch.LongTensor`,形状为 `(batch_size, sequence_length)`,*可选*):用于指示输入中第一和第二部分的段标记索引。索引选自 `[0, 1]`: - 0 对应 *句子 A* 的标记, - 1 对应 *句子 B* 的标记。 [什么是标记类型 ID?](../glossary#token-type-ids)
pixel_values (`torch.Tensor`,形状为 `(batch_size, num_channels, image_size, image_size)`,*可选*) : 与输入图像对应的张量。可以使用 [ViltImageProcessor](/docs/transformers/v5.23.0/zh/model_doc/vilt#transformers.ViltImageProcessor) 获取像素值。有关详细信息,请参阅 [ViltImageProcessor.__call__()](/docs/transformers/v5.23.0/zh/model_doc/molmo2#transformers.Molmo2ImageProcessor.__call__)([ViltProcessor](/docs/transformers/v5.23.0/zh/model_doc/vilt#transformers.ViltProcessor) 使用 [ViltImageProcessor](/docs/transformers/v5.23.0/zh/model_doc/vilt#transformers.ViltImageProcessor) 处理图像)。
pixel_mask (`torch.LongTensor`,形状为 `(batch_size, height, width)`,*可选*):用于避免对填充像素值执行注意力的掩码。掩码值取自 `[0, 1]`: - 1 表示真实像素(即 **未掩码**), - 0 表示填充像素(即 **已掩码**)。 [什么是注意力掩码?](../glossary#attention-mask)
inputs_embeds (`torch.Tensor`,形状为 `(batch_size, sequence_length, hidden_size)`,*可选*):可选地,你可以选择直接传入嵌入表示,而不是传入 `input_ids`。如果你希望比模型内部的嵌入查找矩阵更精细地控制如何将 `input_ids` 索引转换为对应的向量,这将非常有用。
image_embeds (`torch.Tensor`,形状为 `(batch_size, num_patches, hidden_size)`,*可选*):可选地,你可以选择直接传入嵌入表示,而不是传入 `pixel_values`。如果你希望更精细地控制如何将 `pixel_values` 转换为补丁嵌入,这将非常有用。
labels (`torch.LongTensor`,形状为 `(batch_size, sequence_length)`,*可选*):用于计算掩码语言建模损失的标签。索引应在 `[-100, 0, ..., config.vocab_size]` 范围内(参见 `input_ids` 的文档字符串)。索引设置为 `-100` 的令牌将被忽略(掩码),损失仅针对标签在 `[0, ..., config.vocab_size]` 范围内的令牌进行计算。
output_attentions (`bool`, *可选*) : 是否返回所有注意力层的注意力张量。有关更多详细信息,请参阅返回张量中的 `attentions`。
output_hidden_states (`bool`, *可选*) : 是否返回所有层的隐藏状态。有关更多详细信息,请参阅返回张量中的 `hidden_states`。
return_dict (`bool`, *可选*) : 是否返回 [ModelOutput](/docs/transformers/v5.23.0/zh/main_classes/output#transformers.utils.ModelOutput) 而不是普通元组。
**返回:** [MaskedLMOutput](/docs/transformers/v5.23.0/zh/main_classes/output#transformers.modeling_outputs.MaskedLMOutput) 或 `tuple(torch.Tensor)`
一个 [MaskedLMOutput](/docs/transformers/v5.23.0/zh/main_classes/output#transformers.modeling_outputs.MaskedLMOutput) 或 `torch.Tensor` 元组(如果传入了 `return_dict=False` 或 `config.return_dict=False`),其包含的元素取决于配置([ViltConfig](/docs/transformers/v5.23.0/zh/model_doc/vilt#transformers.ViltConfig))和输入。
[ViltForMaskedLM](/docs/transformers/v5.23.0/zh/model_doc/vilt#transformers.ViltForMaskedLM) 的 forward 方法重写了 `__call__` 特殊方法。
尽管前向传播的实现需要在此函数中定义,但之后应调用 `Module` 实例,而不是直接调用此函数,因为前者会负责执行预处理和后处理步骤,而后者会静默地忽略这些步骤。
- **loss** (`torch.Tensor`,形状为 `(1,)`,*可选*,当提供 `labels` 时返回) -- 掩码语言建模(MLM)损失。
- **logits**(形状为 `(batch_size, sequence_length, config.vocab_size)` 的 `torch.Tensor`)-- 语言建模头的预测分数(SoftMax 之前每个词汇表 token 的分数)。
- **hidden_states** (`tuple(torch.Tensor)`,*可选*,在传入 `output_hidden_states=True` 或 `config.output_hidden_states=True` 时返回) -- 一个 `torch.Tensor` 元组(如果模型具有嵌入层,则包含嵌入层的输出,以及每一层的输出),形状为 `(batch_size, sequence_length, hidden_size)`。
模型在每一层输出处的隐藏状态,以及可选的初始嵌入输出。
- **attentions** (`tuple(torch.Tensor)`,*可选*,当传入 `output_attentions=True` 或 `config.output_attentions=True` 时返回) -- 一个 `torch.Tensor` 元组(每层一个),形状为 `(batch_size, num_heads, sequence_length, sequence_length)`。
经过注意力 softmax 后的注意力权重,用于在自注意力头中计算加权平均值。
示例:
```python
>>> from transformers import ViltProcessor, ViltForMaskedLM
>>> from huggingface_hub.utils import httpx
>>> from io import BytesIO
>>> from PIL import Image
>>> import re
>>> import torch
>>> url = "http://images.cocodataset.org/val2017/000000039769.jpg"
>>> with httpx.stream("GET", url) as response:
... image = Image.open(BytesIO(response.read()))
>>> text = "a bunch of [MASK] laying on a [MASK]."
>>> processor = ViltProcessor.from_pretrained("dandelin/vilt-b32-mlm")
>>> model = ViltForMaskedLM.from_pretrained("dandelin/vilt-b32-mlm")
>>> # prepare inputs
>>> encoding = processor(image, text, return_tensors="pt")
>>> # forward pass
>>> outputs = model(**encoding)
>>> tl = len(re.findall("\[MASK\]", text))
>>> inferred_token = [text]
>>> # gradually fill in the MASK tokens, one by one
>>> with torch.no_grad():
... for i in range(tl):
... encoded = processor.tokenizer(inferred_token)
... input_ids = torch.tensor(encoded.input_ids)
... encoded = encoded["input_ids"][0][1:-1]
... outputs = model(input_ids=input_ids, pixel_values=encoding.pixel_values)
... mlm_logits = outputs.logits[0] # shape (seq_len, vocab_size)
... # only take into account text features (minus CLS and SEP token)
... mlm_logits = mlm_logits[1 : input_ids.shape[1] - 1, :]
... mlm_values, mlm_ids = mlm_logits.softmax(dim=-1).max(dim=-1)
... # only take into account text
... mlm_values[torch.tensor(encoded) != 103] = 0
... select = mlm_values.argmax().item()
... encoded[select] = mlm_ids[select].item()
... inferred_token = [processor.decode(encoded)]
>>> selected_token = ""
>>> encoded = processor.tokenizer(inferred_token)
>>> output = processor.decode(encoded.input_ids[0], skip_special_tokens=True)
>>> print(output)
a bunch of cats laying on a couch.
```
## ViltForQuestionAnswering[[transformers.ViltForQuestionAnswering]]
#### transformers.ViltForQuestionAnswering[[transformers.ViltForQuestionAnswering]]
```python
transformers.ViltForQuestionAnswering(config: ViltConfig)
```
[来源](https://github.com/huggingface/transformers/blob/v5.23.0/src/transformers/models/vilt/modeling_vilt.py#L840)
**参数:**
config ([ViltConfig](/docs/transformers/v5.23.0/zh/model_doc/vilt#transformers.ViltConfig)):模型配置类,包含模型的所有参数。使用配置文件进行初始化并不会加载与模型关联的权重,仅加载配置。请查看 [from_pretrained()](/docs/transformers/v5.23.0/zh/main_classes/model#transformers.PreTrainedModel.from_pretrained) 方法以加载模型权重。
Vilt 模型,顶部带有分类器头(在 [CLS] token 的最终隐藏状态之上添加一个线性层),用于视觉问答,例如 VQAv2。
该模型继承自 [PreTrainedModel](/docs/transformers/v5.23.0/zh/main_classes/model#transformers.PreTrainedModel)。请查阅父类文档,了解该库为所有模型实现的通用方法(例如下载或保存、调整输入嵌入大小、剪枝头等)。
该模型也是 PyTorch [torch.nn.Module](https://pytorch.org/docs/stable/nn.html#torch.nn.Module) 的子类。请将其作为常规的 PyTorch Module 使用,有关通用用法和行为的所有事项,请参阅 PyTorch 文档。
#### forward[[transformers.ViltForQuestionAnswering.forward]]
```python
forward(input_ids: typing.Optional[torch.LongTensor] = None, attention_mask: typing.Optional[torch.Tensor] = None, token_type_ids: typing.Optional[torch.LongTensor] = None, pixel_values: typing.Optional[torch.Tensor] = None, pixel_mask: typing.Optional[torch.LongTensor] = None, inputs_embeds: typing.Optional[torch.Tensor] = None, image_embeds: typing.Optional[torch.Tensor] = None, labels: typing.Optional[torch.LongTensor] = None, output_attentions: bool | None = None, output_hidden_states: bool | None = None, return_dict: bool | None = None, **kwargs)
```
[来源](https://github.com/huggingface/transformers/blob/v5.23.0/src/transformers/models/vilt/modeling_vilt.py#L858)
**参数:**
input_ids (`torch.LongTensor`,形状为 `(batch_size, sequence_length)`,*可选*):输入序列中 token 在词汇表中的索引。默认情况下,填充(padding)将被忽略。可以使用 [AutoTokenizer](/docs/transformers/v5.23.0/zh/model_doc/auto#transformers.AutoTokenizer) 获取索引。有关详细信息,请参阅 [PreTrainedTokenizer.encode()](/docs/transformers/v5.23.0/zh/internal/tokenization_utils#transformers.PreTrainedTokenizerBase.encode) 和 [PreTrainedTokenizer.__call__()](/docs/transformers/v5.23.0/zh/internal/tokenization_utils#transformers.PreTrainedTokenizerBase.__call__)。[什么是输入 ID?](../glossary#input-ids)
attention_mask (`torch.Tensor`,形状为 `(batch_size, sequence_length)`,*可选*):用于避免对填充(padding)标记索引执行注意力机制的掩码。掩码值取自 `[0, 1]`: - 1 表示**未掩码**的标记, - 0 表示**已掩码**的标记。 [什么是注意力掩码?](../glossary#attention-mask)
token_type_ids (`torch.LongTensor`,形状为 `(batch_size, sequence_length)`,*可选*):用于指示输入中第一和第二部分的段标记索引。索引选自 `[0, 1]`: - 0 对应 *句子 A* 的标记, - 1 对应 *句子 B* 的标记。 [什么是标记类型 ID?](../glossary#token-type-ids)
pixel_values (`torch.Tensor`,形状为 `(batch_size, num_channels, image_size, image_size)`,*可选*) : 与输入图像对应的张量。可以使用 [ViltImageProcessor](/docs/transformers/v5.23.0/zh/model_doc/vilt#transformers.ViltImageProcessor) 获取像素值。有关详细信息,请参阅 [ViltImageProcessor.__call__()](/docs/transformers/v5.23.0/zh/model_doc/molmo2#transformers.Molmo2ImageProcessor.__call__)([ViltProcessor](/docs/transformers/v5.23.0/zh/model_doc/vilt#transformers.ViltProcessor) 使用 [ViltImageProcessor](/docs/transformers/v5.23.0/zh/model_doc/vilt#transformers.ViltImageProcessor) 处理图像)。
pixel_mask (`torch.LongTensor`,形状为 `(batch_size, height, width)`,*可选*):用于避免对填充像素值执行注意力的掩码。掩码值取自 `[0, 1]`: - 1 表示真实像素(即 **未掩码**), - 0 表示填充像素(即 **已掩码**)。 [什么是注意力掩码?](../glossary#attention-mask)
inputs_embeds (`torch.Tensor`,形状为 `(batch_size, sequence_length, hidden_size)`,*可选*):可选地,你可以选择直接传入嵌入表示,而不是传入 `input_ids`。如果你希望比模型内部的嵌入查找矩阵更精细地控制如何将 `input_ids` 索引转换为对应的向量,这将非常有用。
image_embeds (`torch.Tensor`,形状为 `(batch_size, num_patches, hidden_size)`,*可选*):可选地,你可以选择直接传入嵌入表示,而不是传入 `pixel_values`。如果你希望更精细地控制如何将 `pixel_values` 转换为补丁嵌入,这将非常有用。
labels (`torch.Tensor`,形状为 `(batch_size, num_labels)`,*可选*) : 用于计算视觉问答损失的标签。该张量必须是批处理中给定示例的所有适用答案的独热编码,或指示哪些答案适用的软编码,其中 1.0 为最高分数。
output_attentions (`bool`, *可选*) : 是否返回所有注意力层的注意力张量。有关更多详细信息,请参阅返回张量中的 `attentions`。
output_hidden_states (`bool`, *可选*) : 是否返回所有层的隐藏状态。有关更多详细信息,请参阅返回张量中的 `hidden_states`。
return_dict (`bool`, *可选*) : 是否返回 [ModelOutput](/docs/transformers/v5.23.0/zh/main_classes/output#transformers.utils.ModelOutput) 而不是普通元组。
**返回:** [SequenceClassifierOutput](/docs/transformers/v5.23.0/zh/main_classes/output#transformers.modeling_outputs.SequenceClassifierOutput) 或 `tuple(torch.Tensor)`
一个 [SequenceClassifierOutput](/docs/transformers/v5.23.0/zh/main_classes/output#transformers.modeling_outputs.SequenceClassifierOutput) 或 `torch.Tensor` 元组(如果传入了 `return_dict=False` 或 `config.return_dict=False`),其包含的元素取决于配置([ViltConfig](/docs/transformers/v5.23.0/zh/model_doc/vilt#transformers.ViltConfig))和输入。
[ViltForQuestionAnswering](/docs/transformers/v5.23.0/zh/model_doc/vilt#transformers.ViltForQuestionAnswering) 的 forward 方法重写了 `__call__` 特殊方法。
尽管前向传播的实现需要在此函数中定义,但之后应调用 `Module` 实例,而不是直接调用此函数,因为前者会负责执行预处理和后处理步骤,而后者会静默地忽略这些步骤。
- **loss** (`torch.Tensor`,形状为 `(1,)`,*可选*,当提供 `labels` 时返回) -- 分类损失(如果 config.num_labels==1,则为回归损失)。
- **logits**(形状为 `(batch_size, config.num_labels)` 的 `torch.Tensor`)-- 分类(或当 config.num_labels==1 时为回归)得分(SoftMax 之前)。
- **hidden_states** (`tuple(torch.Tensor)`,*可选*,在传入 `output_hidden_states=True` 或 `config.output_hidden_states=True` 时返回) -- 一个 `torch.Tensor` 元组(如果模型具有嵌入层,则包含嵌入层的输出,以及每一层的输出),形状为 `(batch_size, sequence_length, hidden_size)`。
模型在每一层输出处的隐藏状态,以及可选的初始嵌入输出。
- **attentions** (`tuple(torch.Tensor)`,*可选*,当传入 `output_attentions=True` 或 `config.output_attentions=True` 时返回) -- 一个 `torch.Tensor` 元组(每层一个),形状为 `(batch_size, num_heads, sequence_length, sequence_length)`。
经过注意力 softmax 后的注意力权重,用于在自注意力头中计算加权平均值。
示例:
```python
>>> from transformers import ViltProcessor, ViltForQuestionAnswering
>>> from huggingface_hub.utils import httpx
>>> from io import BytesIO
>>> from PIL import Image
>>> url = "http://images.cocodataset.org/val2017/000000039769.jpg"
>>> with httpx.stream("GET", url) as response:
... image = Image.open(BytesIO(response.read()))
>>> text = "How many cats are there?"
>>> processor = ViltProcessor.from_pretrained("dandelin/vilt-b32-finetuned-vqa")
>>> model = ViltForQuestionAnswering.from_pretrained("dandelin/vilt-b32-finetuned-vqa")
>>> # prepare inputs
>>> encoding = processor(image, text, return_tensors="pt")
>>> # forward pass
>>> outputs = model(**encoding)
>>> logits = outputs.logits
>>> idx = logits.argmax(-1).item()
>>> print("Predicted answer:", model.config.id2label[idx])
Predicted answer: 2
```
## ViltForImagesAndTextClassification[[transformers.ViltForImagesAndTextClassification]]
#### transformers.ViltForImagesAndTextClassification[[transformers.ViltForImagesAndTextClassification]]
```python
transformers.ViltForImagesAndTextClassification(config: ViltConfig)
```
[来源](https://github.com/huggingface/transformers/blob/v5.23.0/src/transformers/models/vilt/modeling_vilt.py#L1052)
**参数:**
config ([ViltConfig](/docs/transformers/v5.23.0/zh/model_doc/vilt#transformers.ViltConfig)):模型配置类,包含模型的所有参数。使用配置文件进行初始化并不会加载与模型关联的权重,仅加载配置。请查看 [from_pretrained()](/docs/transformers/v5.23.0/zh/main_classes/model#transformers.PreTrainedModel.from_pretrained) 方法以加载模型权重。
Vilt 模型,在 Transformer 之上添加了一个分类器头,用于自然语言视觉推理,例如 NLVR2。
该模型继承自 [PreTrainedModel](/docs/transformers/v5.23.0/zh/main_classes/model#transformers.PreTrainedModel)。请查阅父类文档,了解该库为所有模型实现的通用方法(例如下载或保存、调整输入嵌入大小、剪枝头等)。
该模型也是 PyTorch [torch.nn.Module](https://pytorch.org/docs/stable/nn.html#torch.nn.Module) 的子类。请将其作为常规的 PyTorch Module 使用,有关通用用法和行为的所有事项,请参阅 PyTorch 文档。
#### forward[[transformers.ViltForImagesAndTextClassification.forward]]
```python
forward(input_ids: typing.Optional[torch.LongTensor] = None, attention_mask: typing.Optional[torch.Tensor] = None, token_type_ids: typing.Optional[torch.LongTensor] = None, pixel_values: typing.Optional[torch.Tensor] = None, pixel_mask: typing.Optional[torch.LongTensor] = None, inputs_embeds: typing.Optional[torch.Tensor] = None, image_embeds: typing.Optional[torch.Tensor] = None, labels: typing.Optional[torch.LongTensor] = None, output_attentions: bool | None = None, output_hidden_states: bool | None = None, return_dict: bool | None = None, **kwargs)
```
[来源](https://github.com/huggingface/transformers/blob/v5.23.0/src/transformers/models/vilt/modeling_vilt.py#L1071)
**参数:**
input_ids (`torch.LongTensor`,形状为 `(batch_size, sequence_length)`,*可选*):输入序列中 token 在词汇表中的索引。默认情况下,填充(padding)将被忽略。可以使用 [AutoTokenizer](/docs/transformers/v5.23.0/zh/model_doc/auto#transformers.AutoTokenizer) 获取索引。有关详细信息,请参阅 [PreTrainedTokenizer.encode()](/docs/transformers/v5.23.0/zh/internal/tokenization_utils#transformers.PreTrainedTokenizerBase.encode) 和 [PreTrainedTokenizer.__call__()](/docs/transformers/v5.23.0/zh/internal/tokenization_utils#transformers.PreTrainedTokenizerBase.__call__)。[什么是输入 ID?](../glossary#input-ids)
attention_mask (`torch.Tensor`,形状为 `(batch_size, sequence_length)`,*可选*):用于避免对填充(padding)标记索引执行注意力机制的掩码。掩码值取自 `[0, 1]`: - 1 表示**未掩码**的标记, - 0 表示**已掩码**的标记。 [什么是注意力掩码?](../glossary#attention-mask)
token_type_ids (`torch.LongTensor`,形状为 `(batch_size, sequence_length)`,*可选*):用于指示输入中第一和第二部分的段标记索引。索引选自 `[0, 1]`: - 0 对应 *句子 A* 的标记, - 1 对应 *句子 B* 的标记。 [什么是标记类型 ID?](../glossary#token-type-ids)
pixel_values (`torch.Tensor`,形状为 `(batch_size, num_channels, image_size, image_size)`,*可选*) : 与输入图像对应的张量。可以使用 [ViltImageProcessor](/docs/transformers/v5.23.0/zh/model_doc/vilt#transformers.ViltImageProcessor) 获取像素值。有关详细信息,请参阅 [ViltImageProcessor.__call__()](/docs/transformers/v5.23.0/zh/model_doc/molmo2#transformers.Molmo2ImageProcessor.__call__)([ViltProcessor](/docs/transformers/v5.23.0/zh/model_doc/vilt#transformers.ViltProcessor) 使用 [ViltImageProcessor](/docs/transformers/v5.23.0/zh/model_doc/vilt#transformers.ViltImageProcessor) 处理图像)。
pixel_mask (`torch.LongTensor`,形状为 `(batch_size, height, width)`,*可选*):用于避免对填充像素值执行注意力的掩码。掩码值取自 `[0, 1]`: - 1 表示真实像素(即 **未掩码**), - 0 表示填充像素(即 **已掩码**)。 [什么是注意力掩码?](../glossary#attention-mask)
inputs_embeds (`torch.Tensor`,形状为 `(batch_size, sequence_length, hidden_size)`,*可选*):可选地,你可以选择直接传入嵌入表示,而不是传入 `input_ids`。如果你希望比模型内部的嵌入查找矩阵更精细地控制如何将 `input_ids` 索引转换为对应的向量,这将非常有用。
image_embeds (`torch.Tensor`,形状为 `(batch_size, num_patches, hidden_size)`,*可选*):可选地,你可以选择直接传入嵌入表示,而不是传入 `pixel_values`。如果你希望更精细地控制如何将 `pixel_values` 转换为补丁嵌入,这将非常有用。
labels (`torch.LongTensor`,形状为 `(batch_size,)`,*可选*):二分类标签。
output_attentions (`bool`, *可选*) : 是否返回所有注意力层的注意力张量。有关更多详细信息,请参阅返回张量中的 `attentions`。
output_hidden_states (`bool`, *可选*) : 是否返回所有层的隐藏状态。有关更多详细信息,请参阅返回张量中的 `hidden_states`。
return_dict (`bool`, *可选*) : 是否返回 [ModelOutput](/docs/transformers/v5.23.0/zh/main_classes/output#transformers.utils.ModelOutput) 而不是普通元组。
**返回:** `ViltForImagesAndTextClassificationOutput` 或 `tuple(torch.Tensor)`
`ViltForImagesAndTextClassificationOutput` 或 `torch.Tensor` 元组(如果传入了 `return_dict=False` 或 `config.return_dict=False`),其包含的元素取决于配置([ViltConfig](/docs/transformers/v5.23.0/zh/model_doc/vilt#transformers.ViltConfig))和输入。
[ViltForImagesAndTextClassification](/docs/transformers/v5.23.0/zh/model_doc/vilt#transformers.ViltForImagesAndTextClassification) 的 forward 方法重写了 `__call__` 特殊方法。
尽管前向传播的实现需要在此函数中定义,但之后应调用 `Module` 实例,而不是直接调用此函数,因为前者会负责执行预处理和后处理步骤,而后者会静默地忽略这些步骤。
- **loss** (`torch.Tensor`,形状为 `(1,)`,*可选*,当提供 `labels` 时返回) -- 分类损失(如果 config.num_labels==1,则为回归损失)。
- **logits**(形状为 `(batch_size, config.num_labels)` 的 `torch.Tensor`)-- 分类(或当 config.num_labels==1 时为回归)得分(SoftMax 之前)。
- **hidden_states** (`list[tuple(torch.Tensor)]`,*可选*,在传入 `output_hidden_states=True` 或 `config.output_hidden_states=True` 时返回) -- `torch.Tensor` 元组列表(每个图像-文本对对应一个元组,每个元组包含嵌入层的输出以及每一层的输出),形状为 `(batch_size, sequence_length, hidden_size)`。模型在每一层输出处的隐藏状态以及初始嵌入层的输出。
- **attentions** (`list[tuple[torch.Tensor]]`,*可选*,当传入 `output_attentions=True` 或 `config.output_attentions=True` 时返回) -- 一个 `torch.Tensor` 元组(每层一个),形状为 `(batch_size, num_heads, sequence_length, sequence_length)`。
经过注意力 softmax 后的注意力权重,用于在自注意力头中计算加权平均值。
示例:
```python
>>> from transformers import ViltProcessor, ViltForImagesAndTextClassification
>>> from huggingface_hub.utils import httpx
>>> from io import BytesIO
>>> from PIL import Image
>>> url_1 = "https://lil.nlp.cornell.edu/nlvr/exs/ex0_0.jpg"
>>> with httpx.stream("GET", url_1) as response:
... image_1 = Image.open(BytesIO(response.read()))
>>> url_2 = "https://lil.nlp.cornell.edu/nlvr/exs/ex0_1.jpg"
>>> with httpx.stream("GET", url_2) as response:
... image_2 = Image.open(BytesIO(response.read()))
>>> text = "The left image contains twice the number of dogs as the right image."
>>> processor = ViltProcessor.from_pretrained("dandelin/vilt-b32-finetuned-nlvr2")
>>> model = ViltForImagesAndTextClassification.from_pretrained("dandelin/vilt-b32-finetuned-nlvr2")
>>> # prepare inputs
>>> encoding = processor([image_1, image_2], text, return_tensors="pt")
>>> # forward pass
>>> outputs = model(input_ids=encoding.input_ids, pixel_values=encoding.pixel_values.unsqueeze(0))
>>> logits = outputs.logits
>>> idx = logits.argmax(-1).item()
>>> print("Predicted answer:", model.config.id2label[idx])
Predicted answer: True
```
## ViltForImageAndTextRetrieval[[transformers.ViltForImageAndTextRetrieval]]
#### transformers.ViltForImageAndTextRetrieval[[transformers.ViltForImageAndTextRetrieval]]
```python
transformers.ViltForImageAndTextRetrieval(config: ViltConfig)
```
[来源](https://github.com/huggingface/transformers/blob/v5.23.0/src/transformers/models/vilt/modeling_vilt.py#L953)
**参数:**
config ([ViltConfig](/docs/transformers/v5.23.0/zh/model_doc/vilt#transformers.ViltConfig)):模型配置类,包含模型的所有参数。使用配置文件进行初始化并不会加载与模型关联的权重,仅加载配置。请查看 [from_pretrained()](/docs/transformers/v5.23.0/zh/main_classes/model#transformers.PreTrainedModel.from_pretrained) 方法以加载模型权重。
Vilt 模型,顶部带有分类器头(在 [CLS] token 的最终隐藏状态之上添加一个线性层),用于图像到文本或文本到图像的检索,例如 MSCOCO 和 F30K。
该模型继承自 [PreTrainedModel](/docs/transformers/v5.23.0/zh/main_classes/model#transformers.PreTrainedModel)。请查阅父类文档,了解该库为所有模型实现的通用方法(例如下载或保存、调整输入嵌入大小、剪枝头等)。
该模型也是 PyTorch [torch.nn.Module](https://pytorch.org/docs/stable/nn.html#torch.nn.Module) 的子类。请将其作为常规的 PyTorch Module 使用,有关通用用法和行为的所有事项,请参阅 PyTorch 文档。
#### forward[[transformers.ViltForImageAndTextRetrieval.forward]]
```python
forward(input_ids: typing.Optional[torch.LongTensor] = None, attention_mask: typing.Optional[torch.Tensor] = None, token_type_ids: typing.Optional[torch.LongTensor] = None, pixel_values: typing.Optional[torch.Tensor] = None, pixel_mask: typing.Optional[torch.LongTensor] = None, inputs_embeds: typing.Optional[torch.Tensor] = None, image_embeds: typing.Optional[torch.Tensor] = None, labels: typing.Optional[torch.LongTensor] = None, output_attentions: bool | None = None, output_hidden_states: bool | None = None, return_dict: bool | None = None, **kwargs)
```
[来源](https://github.com/huggingface/transformers/blob/v5.23.0/src/transformers/models/vilt/modeling_vilt.py#L965)
**参数:**
input_ids (`torch.LongTensor`,形状为 `(batch_size, sequence_length)`,*可选*):输入序列中 token 在词汇表中的索引。默认情况下,填充(padding)将被忽略。可以使用 [AutoTokenizer](/docs/transformers/v5.23.0/zh/model_doc/auto#transformers.AutoTokenizer) 获取索引。有关详细信息,请参阅 [PreTrainedTokenizer.encode()](/docs/transformers/v5.23.0/zh/internal/tokenization_utils#transformers.PreTrainedTokenizerBase.encode) 和 [PreTrainedTokenizer.__call__()](/docs/transformers/v5.23.0/zh/internal/tokenization_utils#transformers.PreTrainedTokenizerBase.__call__)。[什么是输入 ID?](../glossary#input-ids)
attention_mask (`torch.Tensor`,形状为 `(batch_size, sequence_length)`,*可选*):用于避免对填充(padding)标记索引执行注意力机制的掩码。掩码值取自 `[0, 1]`: - 1 表示**未掩码**的标记, - 0 表示**已掩码**的标记。 [什么是注意力掩码?](../glossary#attention-mask)
token_type_ids (`torch.LongTensor`,形状为 `(batch_size, sequence_length)`,*可选*):用于指示输入中第一和第二部分的段标记索引。索引选自 `[0, 1]`: - 0 对应 *句子 A* 的标记, - 1 对应 *句子 B* 的标记。 [什么是标记类型 ID?](../glossary#token-type-ids)
pixel_values (`torch.Tensor`,形状为 `(batch_size, num_channels, image_size, image_size)`,*可选*) : 与输入图像对应的张量。可以使用 [ViltImageProcessor](/docs/transformers/v5.23.0/zh/model_doc/vilt#transformers.ViltImageProcessor) 获取像素值。有关详细信息,请参阅 [ViltImageProcessor.__call__()](/docs/transformers/v5.23.0/zh/model_doc/molmo2#transformers.Molmo2ImageProcessor.__call__)([ViltProcessor](/docs/transformers/v5.23.0/zh/model_doc/vilt#transformers.ViltProcessor) 使用 [ViltImageProcessor](/docs/transformers/v5.23.0/zh/model_doc/vilt#transformers.ViltImageProcessor) 处理图像)。
pixel_mask (`torch.LongTensor`,形状为 `(batch_size, height, width)`,*可选*):用于避免对填充像素值执行注意力的掩码。掩码值取自 `[0, 1]`: - 1 表示真实像素(即 **未掩码**), - 0 表示填充像素(即 **已掩码**)。 [什么是注意力掩码?](../glossary#attention-mask)
inputs_embeds (`torch.Tensor`,形状为 `(batch_size, sequence_length, hidden_size)`,*可选*):可选地,你可以选择直接传入嵌入表示,而不是传入 `input_ids`。如果你希望比模型内部的嵌入查找矩阵更精细地控制如何将 `input_ids` 索引转换为对应的向量,这将非常有用。
image_embeds (`torch.Tensor`,形状为 `(batch_size, num_patches, hidden_size)`,*可选*):可选地,你可以选择直接传入嵌入表示,而不是传入 `pixel_values`。如果你希望更精细地控制如何将 `pixel_values` 转换为补丁嵌入,这将非常有用。
labels (`torch.LongTensor`,形状为 `(batch_size,)`,*可选*):目前不支持标签。
output_attentions (`bool`, *可选*) : 是否返回所有注意力层的注意力张量。有关更多详细信息,请参阅返回张量中的 `attentions`。
output_hidden_states (`bool`, *可选*) : 是否返回所有层的隐藏状态。有关更多详细信息,请参阅返回张量中的 `hidden_states`。
return_dict (`bool`, *可选*) : 是否返回 [ModelOutput](/docs/transformers/v5.23.0/zh/main_classes/output#transformers.utils.ModelOutput) 而不是普通元组。
**返回:** [SequenceClassifierOutput](/docs/transformers/v5.23.0/zh/main_classes/output#transformers.modeling_outputs.SequenceClassifierOutput) 或 `tuple(torch.Tensor)`
一个 [SequenceClassifierOutput](/docs/transformers/v5.23.0/zh/main_classes/output#transformers.modeling_outputs.SequenceClassifierOutput) 或 `torch.Tensor` 元组(如果传入了 `return_dict=False` 或 `config.return_dict=False`),其包含的元素取决于配置([ViltConfig](/docs/transformers/v5.23.0/zh/model_doc/vilt#transformers.ViltConfig))和输入。
[ViltForImageAndTextRetrieval](/docs/transformers/v5.23.0/zh/model_doc/vilt#transformers.ViltForImageAndTextRetrieval) 的 forward 方法重写了 `__call__` 特殊方法。
尽管前向传播的实现需要在此函数中定义,但之后应调用 `Module` 实例,而不是直接调用此函数,因为前者会负责执行预处理和后处理步骤,而后者会静默地忽略这些步骤。
- **loss** (`torch.Tensor`,形状为 `(1,)`,*可选*,当提供 `labels` 时返回) -- 分类损失(如果 config.num_labels==1,则为回归损失)。
- **logits**(形状为 `(batch_size, config.num_labels)` 的 `torch.Tensor`)-- 分类(或当 config.num_labels==1 时为回归)得分(SoftMax 之前)。
- **hidden_states** (`tuple(torch.Tensor)`,*可选*,在传入 `output_hidden_states=True` 或 `config.output_hidden_states=True` 时返回) -- 一个 `torch.Tensor` 元组(如果模型具有嵌入层,则包含嵌入层的输出,以及每一层的输出),形状为 `(batch_size, sequence_length, hidden_size)`。
模型在每一层输出处的隐藏状态,以及可选的初始嵌入输出。
- **attentions** (`tuple(torch.Tensor)`,*可选*,当传入 `output_attentions=True` 或 `config.output_attentions=True` 时返回) -- 一个 `torch.Tensor` 元组(每层一个),形状为 `(batch_size, num_heads, sequence_length, sequence_length)`。
经过注意力 softmax 后的注意力权重,用于在自注意力头中计算加权平均值。
示例:
```python
>>> from transformers import ViltProcessor, ViltForImageAndTextRetrieval
>>> from huggingface_hub.utils import httpx
>>> from io import BytesIO
>>> from PIL import Image
>>> url = "http://images.cocodataset.org/val2017/000000039769.jpg"
>>> with httpx.stream("GET", url) as response:
... image = Image.open(BytesIO(response.read()))
>>> texts = ["An image of two cats chilling on a couch", "A football player scoring a goal"]
>>> processor = ViltProcessor.from_pretrained("dandelin/vilt-b32-finetuned-coco")
>>> model = ViltForImageAndTextRetrieval.from_pretrained("dandelin/vilt-b32-finetuned-coco")
>>> # forward pass
>>> scores = dict()
>>> for text in texts:
... # prepare inputs
... encoding = processor(image, text, return_tensors="pt")
... outputs = model(**encoding)
... scores[text] = outputs.logits[0, :].item()
```
## ViltForTokenClassification[[transformers.ViltForTokenClassification]]
#### transformers.ViltForTokenClassification[[transformers.ViltForTokenClassification]]
```python
transformers.ViltForTokenClassification(config: ViltConfig)
```
[来源](https://github.com/huggingface/transformers/blob/v5.23.0/src/transformers/models/vilt/modeling_vilt.py#L1194)
**参数:**
config ([ViltConfig](/docs/transformers/v5.23.0/zh/model_doc/vilt#transformers.ViltConfig)):模型配置类,包含模型的所有参数。使用配置文件进行初始化并不会加载与模型关联的权重,仅加载配置。请查看 [from_pretrained()](/docs/transformers/v5.23.0/zh/main_classes/model#transformers.PreTrainedModel.from_pretrained) 方法以加载模型权重。
带有令牌分类头(即在隐藏状态输出之上添加一个线性层)的 Vilt 变换器,例如用于命名实体识别(NER)任务。
该模型继承自 [PreTrainedModel](/docs/transformers/v5.23.0/zh/main_classes/model#transformers.PreTrainedModel)。请查阅父类文档,了解该库为所有模型实现的通用方法(例如下载或保存、调整输入嵌入大小、剪枝头等)。
该模型也是 PyTorch [torch.nn.Module](https://pytorch.org/docs/stable/nn.html#torch.nn.Module) 的子类。请将其作为常规的 PyTorch Module 使用,有关通用用法和行为的所有事项,请参阅 PyTorch 文档。
#### forward[[transformers.ViltForTokenClassification.forward]]
```python
forward(input_ids: typing.Optional[torch.LongTensor] = None, attention_mask: typing.Optional[torch.Tensor] = None, token_type_ids: typing.Optional[torch.LongTensor] = None, pixel_values: typing.Optional[torch.Tensor] = None, pixel_mask: typing.Optional[torch.LongTensor] = None, inputs_embeds: typing.Optional[torch.Tensor] = None, image_embeds: typing.Optional[torch.Tensor] = None, labels: typing.Optional[torch.LongTensor] = None, output_attentions: bool | None = None, output_hidden_states: bool | None = None, return_dict: bool | None = None, **kwargs)
```
[来源](https://github.com/huggingface/transformers/blob/v5.23.0/src/transformers/models/vilt/modeling_vilt.py#L1207)
**参数:**
input_ids (`torch.LongTensor`,形状为 `(batch_size, sequence_length)`,*可选*):输入序列中 token 在词汇表中的索引。默认情况下,填充(padding)将被忽略。可以使用 [AutoTokenizer](/docs/transformers/v5.23.0/zh/model_doc/auto#transformers.AutoTokenizer) 获取索引。有关详细信息,请参阅 [PreTrainedTokenizer.encode()](/docs/transformers/v5.23.0/zh/internal/tokenization_utils#transformers.PreTrainedTokenizerBase.encode) 和 [PreTrainedTokenizer.__call__()](/docs/transformers/v5.23.0/zh/internal/tokenization_utils#transformers.PreTrainedTokenizerBase.__call__)。[什么是输入 ID?](../glossary#input-ids)
attention_mask (`torch.Tensor`,形状为 `(batch_size, sequence_length)`,*可选*):用于避免对填充(padding)标记索引执行注意力机制的掩码。掩码值取自 `[0, 1]`: - 1 表示**未掩码**的标记, - 0 表示**已掩码**的标记。 [什么是注意力掩码?](../glossary#attention-mask)
token_type_ids (`torch.LongTensor`,形状为 `(batch_size, sequence_length)`,*可选*):用于指示输入中第一和第二部分的段标记索引。索引选自 `[0, 1]`: - 0 对应 *句子 A* 的标记, - 1 对应 *句子 B* 的标记。 [什么是标记类型 ID?](../glossary#token-type-ids)
pixel_values (`torch.Tensor`,形状为 `(batch_size, num_channels, image_size, image_size)`,*可选*) : 与输入图像对应的张量。可以使用 [ViltImageProcessor](/docs/transformers/v5.23.0/zh/model_doc/vilt#transformers.ViltImageProcessor) 获取像素值。有关详细信息,请参阅 [ViltImageProcessor.__call__()](/docs/transformers/v5.23.0/zh/model_doc/molmo2#transformers.Molmo2ImageProcessor.__call__)([ViltProcessor](/docs/transformers/v5.23.0/zh/model_doc/vilt#transformers.ViltProcessor) 使用 [ViltImageProcessor](/docs/transformers/v5.23.0/zh/model_doc/vilt#transformers.ViltImageProcessor) 处理图像)。
pixel_mask (`torch.LongTensor`,形状为 `(batch_size, height, width)`,*可选*):用于避免对填充像素值执行注意力的掩码。掩码值取自 `[0, 1]`: - 1 表示真实像素(即 **未掩码**), - 0 表示填充像素(即 **已掩码**)。 [什么是注意力掩码?](../glossary#attention-mask)
inputs_embeds (`torch.Tensor`,形状为 `(batch_size, sequence_length, hidden_size)`,*可选*):可选地,你可以选择直接传入嵌入表示,而不是传入 `input_ids`。如果你希望比模型内部的嵌入查找矩阵更精细地控制如何将 `input_ids` 索引转换为对应的向量,这将非常有用。
image_embeds (`torch.Tensor`,形状为 `(batch_size, num_patches, hidden_size)`,*可选*):可选地,你可以选择直接传入嵌入表示,而不是传入 `pixel_values`。如果你希望更精细地控制如何将 `pixel_values` 转换为补丁嵌入,这将非常有用。
labels (`torch.LongTensor`,形状为 `(batch_size, text_sequence_length)`,*可选*):用于计算 token 分类损失的标签。索引应在 `[0, ..., config.num_labels - 1]` 范围内。
output_attentions (`bool`, *可选*) : 是否返回所有注意力层的注意力张量。有关更多详细信息,请参阅返回张量中的 `attentions`。
output_hidden_states (`bool`, *可选*) : 是否返回所有层的隐藏状态。有关更多详细信息,请参阅返回张量中的 `hidden_states`。
return_dict (`bool`, *可选*) : 是否返回 [ModelOutput](/docs/transformers/v5.23.0/zh/main_classes/output#transformers.utils.ModelOutput) 而不是普通元组。
**返回:** [TokenClassifierOutput](/docs/transformers/v5.23.0/zh/main_classes/output#transformers.modeling_outputs.TokenClassifierOutput) 或 `tuple(torch.Tensor)`
一个 [TokenClassifierOutput](/docs/transformers/v5.23.0/zh/main_classes/output#transformers.modeling_outputs.TokenClassifierOutput) 或 `torch.Tensor` 元组(如果传入了 `return_dict=False` 或 `config.return_dict=False`),其包含的元素取决于配置([ViltConfig](/docs/transformers/v5.23.0/zh/model_doc/vilt#transformers.ViltConfig))和输入。
[ViltForTokenClassification](/docs/transformers/v5.23.0/zh/model_doc/vilt#transformers.ViltForTokenClassification) 的 forward 方法重写了 `__call__` 特殊方法。
尽管前向传播的实现需要在此函数中定义,但之后应调用 `Module` 实例,而不是直接调用此函数,因为前者会负责执行预处理和后处理步骤,而后者会静默地忽略这些步骤。
- **loss** (`torch.Tensor`,形状为 `(1,)`,*可选*,在提供 `labels` 时返回) -- 分类损失。
- **logits**(形状为 `(batch_size, sequence_length, config.num_labels)` 的 `torch.Tensor`)-- 分类分数(SoftMax 之前)。
- **hidden_states** (`tuple(torch.Tensor)`,*可选*,在传入 `output_hidden_states=True` 或 `config.output_hidden_states=True` 时返回) -- 一个 `torch.Tensor` 元组(如果模型具有嵌入层,则包含嵌入层的输出,以及每一层的输出),形状为 `(batch_size, sequence_length, hidden_size)`。
模型在每一层输出处的隐藏状态,以及可选的初始嵌入输出。
- **attentions** (`tuple(torch.Tensor)`,*可选*,当传入 `output_attentions=True` 或 `config.output_attentions=True` 时返回) -- 一个 `torch.Tensor` 元组(每层一个),形状为 `(batch_size, num_heads, sequence_length, sequence_length)`。
经过注意力 softmax 后的注意力权重,用于在自注意力头中计算加权平均值。
示例:
```python
>>> from transformers import AutoTokenizer, ViltForTokenClassification
>>> import torch
>>> tokenizer = AutoTokenizer.from_pretrained("dandelin/vilt-b32-mlm")
>>> model = ViltForTokenClassification.from_pretrained("dandelin/vilt-b32-mlm")
>>> inputs = tokenizer(
... "HuggingFace is a company based in Paris and New York", add_special_tokens=False, return_tensors="pt"
... )
>>> with torch.no_grad():
... logits = model(**inputs).logits
>>> predicted_token_class_ids = logits.argmax(-1)
>>> # Note that tokens are classified rather then input words which means that
>>> # there might be more predicted token classes than words.
>>> # Multiple token classes might account for the same word
>>> predicted_tokens_classes = [model.config.id2label[t.item()] for t in predicted_token_class_ids[0]]
>>> predicted_tokens_classes
...
>>> labels = predicted_token_class_ids
>>> loss = model(**inputs, labels=labels).loss
>>> round(loss.item(), 2)
...
```