
Hub documentation
Uso de espacios de GPU
Uso de espacios de GPU
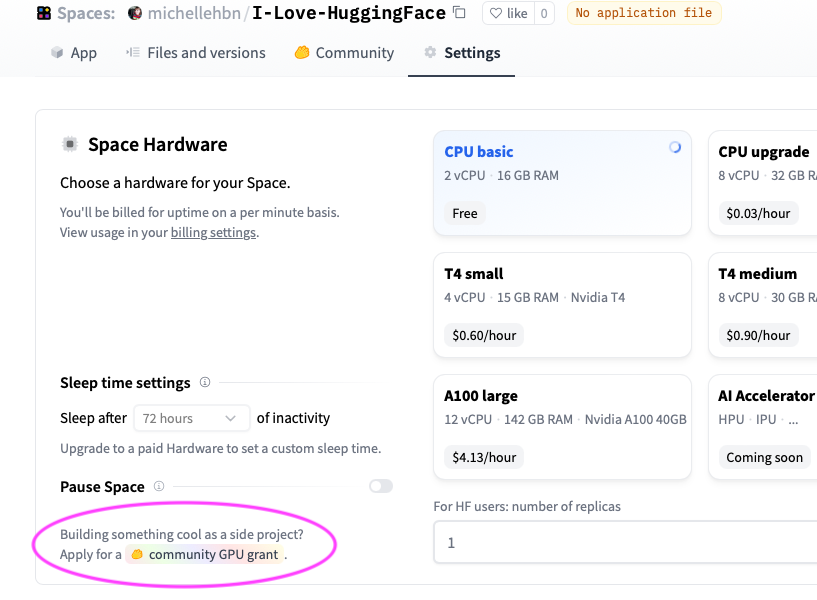
Puedes actualizar tu Space para usar un acelerador GPU mediante el botón Settings en la barra de navegación superior del Space. Incluso puedes solicitar una actualización gratuita si estás creando una demo interesante para un proyecto secundario.


A largo plazo, también nos gustaría exponer hardware no basado en GPU, como HPU, IPU o TPU. Si tienes un hardware de IA específico en el que te gustaría ejecutarlo, infórmalo (sitio web en huggingface.co).
En cuanto tu Space esté funcionando en GPU, puedes ver directamente en esta insignia qué hardware está utilizando:

Especificaciones de hardware
En las siguientes tablas, puede ver las especificaciones de las diferentes opciones de actualización.
CPU
| Hardware | CPU | Memoria | Memoria de GPU | Disco | Precio por hora |
|---|---|---|---|---|---|
| Básico de CPU | 2 vCPU | 16 GB | - | 50 GB | ¡Gratis! |
| Mejora de CPU | 8 vCPU | 32 GB | - | 50 GB | $0.03 |
CPU Basic no tiene un costo por hora, pero crear un nuevo Space que se ejecute en compute (Gradio o Docker) requiere un plan de pago. Los Spaces estáticos son gratuitos para todos. Consulta el Spaces Overview para más detalles.
GPU
| Hardware | CPU | Memoria | Memoria de GPU | Disco | Precio por hora |
|---|---|---|---|---|---|
| Nvidia T4 - pequeño | 4 vCPU | 15 GB | 16 GB | 50 GB | $0.40 |
| Nvidia T4 - medio | 8 vCPU | 30 GB | 16 GB | 100 GB | $0.60 |
| 1x Nvidia L4 | 8 vCPU | 30 GB | 24 GB | 400 GB | $0.80 |
| 4x Nvidia L4 | 48 vCPU | 186 GB | 96 GB | 3200 GB | $3.80 |
| 1x Nvidia L40S | 8 vCPU | 62 GB | 48 GB | 380 GB | $1.80 |
| 4x Nvidia L40S | 48 vCPU | 382 GB | 192 GB | 3200 GB | $8.30 |
| 8x Nvidia L40S | 192 vCPU | 1534 GB | 384 GB | 6500 GB | $23.50 |
| 1x Nvidia RTX PRO 6000 | 23 vCPU | 256 GB | 96 GB | 475 GB | $2.75 |
| 2x Nvidia RTX PRO 6000 | 46 vCPU | 512 GB | 192 GB | 950 GB | $5.50 |
| 4x Nvidia RTX PRO 6000 | 92 vCPU | 1024 GB | 384 GB | 1900 GB | $11.00 |
| 8x Nvidia RTX PRO 6000 | 184 vCPU | 2048 GB | 768 GB | 3800 GB | $22.00 |
| Nvidia A10G - pequeño | 4 vCPU | 15 GB | 24 GB | 110 GB | $1.00 |
| Nvidia A10G - grande | 12 vCPU | 46 GB | 24 GB | 200 GB | $1.50 |
| 2x Nvidia A10G - grande | 24 vCPU | 92 GB | 48 GB | 1000 GB | $3.00 |
| 4x Nvidia A10G - grande | 48 vCPU | 184 GB | 96 GB | 2000 GB | $5.00 |
| Nvidia A100 - grande | 12 vCPU | 142 GB | 80 GB | 1000 GB | $2.50 |
| 4x Nvidia A100 | 48 vCPU | 568 GB | 320 GB | 4000 GB | $10.00 |
| 8x Nvidia A100 | 96 vCPU | 1136 GB | 640 GB | 8000 GB | $20.00 |
Configurar el hardware de forma programática
Puedes configurar el hardware de tu Space de forma programática mediante huggingface_hub. Esto permite una amplia gama de casos de uso en los que necesitas asignar GPUs de manera dinámica.
Consulta esta guía para más detalles.
Requisitos específicos del framework
La mayoría de los Spaces deberían funcionar sin cambios tras una actualización de GPU, pero a veces será necesario instalar las versiones CUDA de los frameworks de machine learning que utilices. Siga esta guía para asegurarse de que su Space aproveche el hardware mejorado.
PyTorch
Deberás instalar una versión de PyTorch compatible con los controladores CUDA integrados. Agregar las siguientes dos líneas a tu archivo requirements.txt debería funcionar:
--extra-index-url https://download.pytorch.org/whl/cu113
torch
Puedes verificar si la instalación fue exitosa ejecutando el siguiente código en tu app.py y revisando la salida en los registros de tu Space:
import torch
print(f"Is CUDA available: {torch.cuda.is_available()}")
# True
print(f"CUDA device: {torch.cuda.get_device_name(torch.cuda.current_device())}")
# Tesla T4
Muchos marcos de trabajo utilizan automáticamente la GPU si está disponible. Este es el caso de los Pipelines de 🤗 transformers, fastai y muchos otros. En otros casos, o si usas PyTorch directamente, es posible que necesites mover tus modelos y datos a la GPU para asegurarte de que el cálculo se realice en el acelerador y no en la CPU. Puedes usar la sintaxis .to() de PyTorch, por ejemplo:
model = load_pytorch_model()
model = model.to("cuda")
JAX
Si usas JAX, debes especificar la URL que contiene los paquetes compatibles con CUDA. Añade las siguientes líneas a tu archivo requirements.txt:
-f https://storage.googleapis.com/jax-releases/jax_cuda_releases.html
jax[cuda11_pip]
jaxlib
Después de eso, puede verificar la instalación imprimiendo la salida del siguiente código y comprobándola en los registros de su Space.
import jax

print(f"JAX devices: {jax.devices()}")
# JAX devices: [StreamExecutorGpuDevice(id=0, process_index=0)]
print(f"JAX device type: {jax.devices()[0].device_kind}")
# JAX device type: Tesla T4
TensorFlow
La instalación predeterminada de tensorflow debería reconocer el dispositivo CUDA. Solo tienes que añadir tensorflow a tu archivo requirements.txt y usar el siguiente código en tu app.py para verificarlo en los registros de tu Space.
import tensorflow as tf
print(tf.config.list_physical_devices('GPU'))
# [PhysicalDevice(name='/physical_device:GPU:0', device_type='GPU')]
Facturación
La facturación en Spaces se basa en el uso de hardware y se calcula por minuto: se cobra por cada minuto que el Space se ejecuta en el hardware solicitado, independientemente de si el Space se utiliza o no.
Durante el ciclo de vida de un Space, solo se genera un cargo cuando el Space está en estado Starting o Running. Esto significa que no hay ningún coste durante la compilación.
Si un Space en ejecución comienza a fallar, se suspenderá automáticamente y se detendrá la facturación.
Los Spaces que se ejecutan en hardware gratuito se suspenden automáticamente si no se utilizan durante un período prolongado (por ejemplo, dos días). Los Spaces actualizados se ejecutan de forma indefinida por defecto, incluso si no hay uso. Puedes cambiar este comportamiento estableciendo un “tiempo de suspensión” personalizado en la configuración del Space. Para interrumpir la facturación de tu Space, puedes cambiar el Hardware a CPU básico o pausarlo.
Puede encontrar información adicional sobre la facturación en la sección dedicada a todo el Hub.
Subvenciones de GPU para la comunidad
¿Tienes un Space increíble pero necesitas ayuda para cubrir los costos de la actualización del hardware de GPU? Nos encanta ayudar a quienes tienen un Space innovador, así que no dudes en solicitar una subvención de GPU de la comunidad y ver si el tuyo cumple con los requisitos. Esta solicitud se encuentra en la configuración del repositorio de hardware de tu Space, en la esquina inferior izquierda, bajo “sleep time settings”:
Establecer un tiempo de suspensión personalizado
Si tu Space se ejecuta en el hardware predeterminado cpu-basic, entrará en modo de suspensión si permanece inactivo durante más de un tiempo establecido (actualmente, 48 horas). Cualquier persona que visite tu Space lo reiniciará automáticamente.
Si deseas que tu Space nunca se desactive o si quieres establecer un tiempo de suspensión personalizado, necesitas actualizar a hardware de pago.
Por defecto, un Space actualizado nunca entrará en modo de suspensión. Sin embargo, puedes usar esta configuración para que tu Space actualizado quede inactivo (etapa stopped) cuando no se utilice 😴. No se te cobrará por el hardware actualizado mientras esté en modo de suspensión. El Space se “despertará” o se reiniciará cuando reciba una nueva visita.
A continuación, esta interfaz estará disponible en la configuración de hardware de tus Spaces:
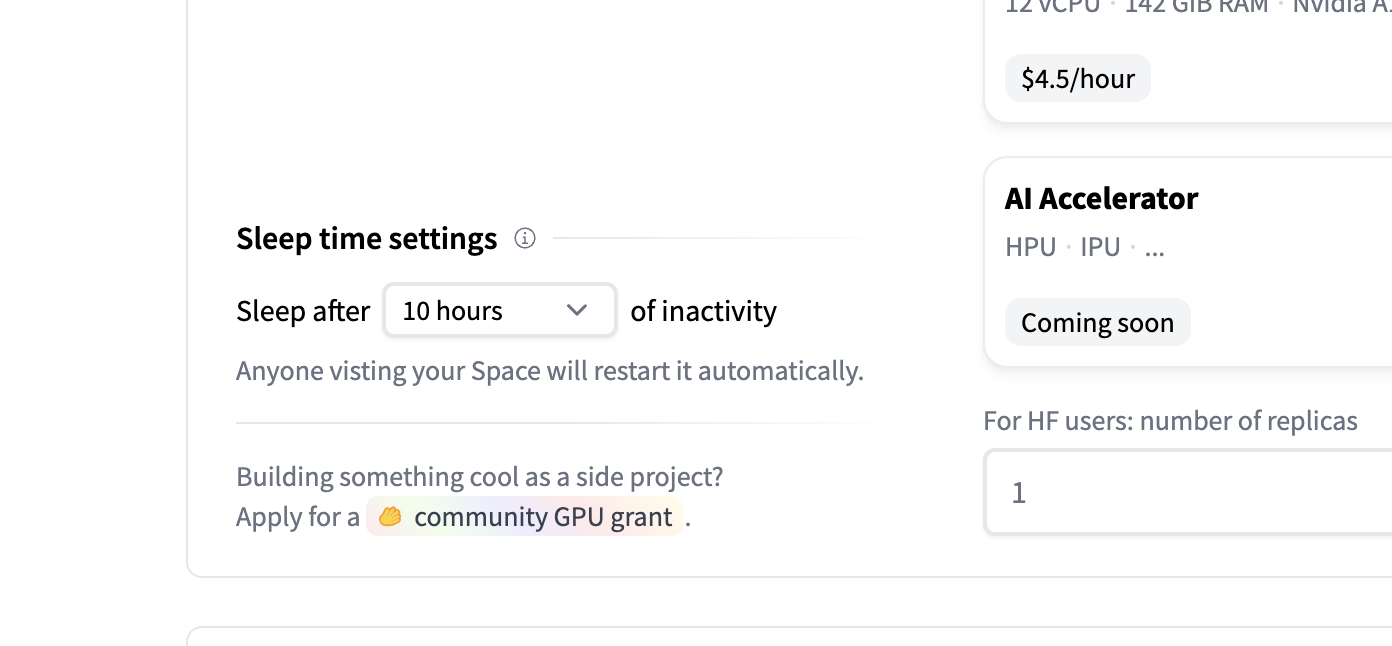

Estas son las opciones disponibles:


Réplicas
Puedes escalar tu Space horizontalmente solicitando múltiples réplicas. Esto distribuye el tráfico entre varias instancias de tu Space para mejorar la disponibilidad y el rendimiento. Puedes establecer el número de réplicas a través de la API:
POST https://huggingface.co/api/spaces/{namespace}/{repo}/replicas
Content-Type: application/json

{
  "replicas": 2
}
Las réplicas solo están disponibles para hardware actualizado (de pago). Cada réplica se factura de forma independiente.
Registro de eventos, métricas y registros en streaming
Puedes transmitir en tiempo real registros, eventos de estado y métricas de tu Space mediante SSE (Server-Sent Events):
- Registros de compilación o ejecución:
GET /api/spaces/{namespace}/{repo}/logs/{build|run} - Eventos de estado:
GET /api/spaces/{namespace}/{repo}/events - Métricas:
GET /api/spaces/{namespace}/{repo}/metrics
Estos puntos de acceso requieren autenticación y devuelven datos usando el protocolo SSE.
El punto de acceso de registros acepta un parámetro de consulta opcional tail (entero no negativo) para limitar la respuesta a las últimas N líneas de registros:
GET /api/spaces/{namespace}/{repo}/logs/{build|run}?tail=100Pausar un Space
Puedes pause un Space desde la configuración del repositorio. Un Space “paused” significa que el Space está en pausa y no utilizará recursos hasta que se reinicie manualmente. Cualquier persona con acceso de escritura al Space puede pausarlo o reiniciarlo. El tiempo en pausa no se factura.