
PEFT documentation
LoRA
LoRA
LoRA é um dos métodos PEFT mais populares e um bom ponto de partida se você está começando a usar PEFT. Foi desenvolvido originalmente para modelos de linguagem de grande escala, mas é um método de treinamento extremamente popular para modelos de difusão devido à sua eficiência e eficácia.
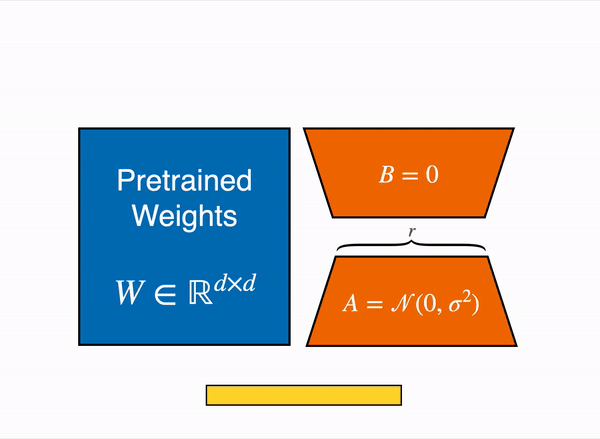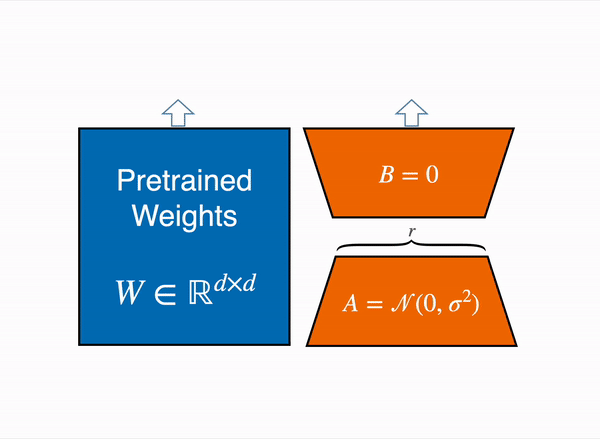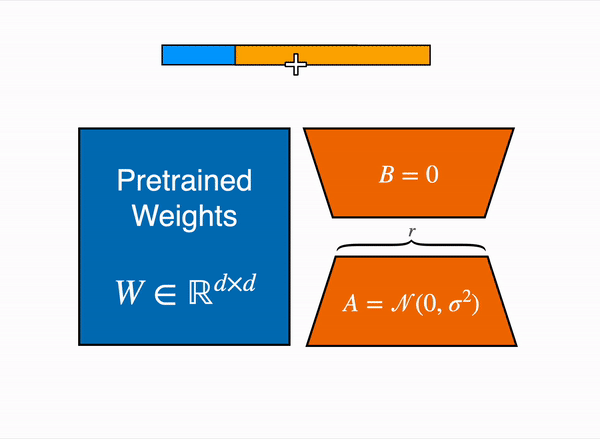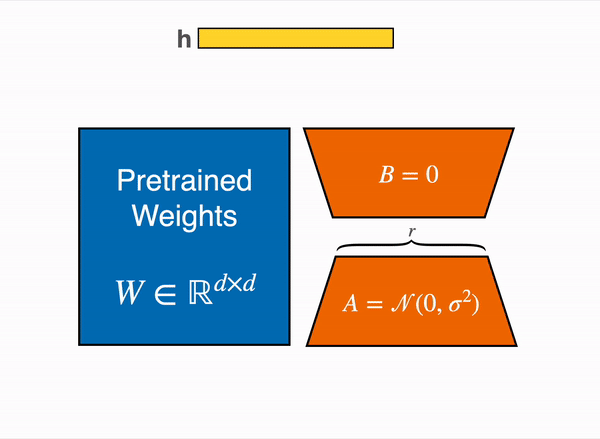
A Low-Rank Adaptation (LoRA) é um método PEFT que decompõe uma grande matriz em duas matrizes menores de baixo posto. Isso reduz drasticamente o número de parâmetros que precisam ser ajustados.
O resumo do artigo é:
Um paradigma importante do processamento de linguagem natural consiste no pré-treinamento em larga escala em dados de domínio geral e na adaptação a tarefas ou domínios específicos. À medida que pré-treinamos modelos maiores, o ajuste fino completo, que retreina todos os parâmetros do modelo, torna-se menos viável. Usando o GPT-3 175B como exemplo — implantar instâncias independentes de modelos ajustados, cada uma com 175B parâmetros, é proibitivamente caro. Propomos a Low-Rank Adaptation, ou LoRA, que congela os pesos do modelo pré-treinado e injeta matrizes de decomposição de posto treináveis em cada camada da arquitetura Transformer, reduzindo drasticamente o número de parâmetros treináveis para tarefas de baixo nível. Em comparação com o GPT-3 175B ajustado com Adam, o LoRA pode reduzir o número de parâmetros treináveis em 10.000 vezes e o requisito de memória de GPU em 3 vezes. O LoRA apresenta desempenho igual ou superior ao do ajuste fino em qualidade de modelo no RoBERTa, DeBERTa, GPT-2 e GPT-3, apesar de ter menos parâmetros treináveis, um throughput de treinamento mais alto e, diferentemente dos adaptadores, nenhuma latência adicional de inferência. Também fornecemos uma investigação empírica sobre a deficiência de posto na adaptação de modelos de linguagem, que lança luz sobre a eficácia do LoRA. Liberamos um pacote que facilita a integração do LoRA com modelos PyTorch e fornecemos nossas implementações e checkpoints de modelo para RoBERTa, DeBERTa e GPT-2 em this https URL.
LoRA representa as atualizações de pesos com duas matrizes menores (chamadas de matrizes de atualização) por meio de decomposição de baixo posto. Essas novas matrizes podem ser treinadas para se adaptar aos novos dados, mantendo o número total de parâmetros baixo. A matriz de pesos original permanece congelada e não recebe mais atualizações. Para produzir os resultados finais, os pesos originais e os pesos adaptados extras são combinados. Você também pode mesclar os pesos do adaptador com o modelo base para eliminar a latência de inferência.
Essa abordagem apresenta uma série de vantagens:
- LoRA torna o ajuste fino mais eficiente ao reduzir drasticamente o número de parâmetros treináveis.
- Os pesos pré-treinados originais são mantidos congelados, o que significa que você pode ter vários modelos LoRA leves e portáveis para diversas tarefas de baixo nível construídos sobre eles.
- LoRA é ortogonal a outros métodos de eficiência de parâmetros e pode ser combinado com muitos deles.
- O desempenho de modelos ajustados usando LoRA é comparável ao desempenho de modelos totalmente ajustados.
Em princípio, o LoRA pode ser aplicado a qualquer subconjunto de matrizes de pesos em uma rede neural para reduzir o número de parâmetros treináveis. No entanto, por simplicidade e maior eficiência de parâmetros, o LoRA é tipicamente aplicado apenas aos blocos de atenção em modelos Transformer - pode valer a pena direcionar também outras camadas. O número resultante de parâmetros treináveis em um modelo LoRA depende do tamanho das matrizes de atualização, que é determinado principalmente pelo rank r e pela forma da matriz de pesos original.
Você pode inicializar as matrizes de baixo rank com diferentes casos de uso em mente - consciência de tarefa (CorDA, EVA, Astra), convergência mais rápida (PiSSA), mitigação de quantizações (LoftQ) - para citar apenas alguns casos de uso. Leia sobre as diferentes inicializações abaixo. A inicialização padrão é para que o LoRA seja um no-op, aprendendo gradualmente um novo comportamento sem interferir muito no modelo existente.
Uso
O tamanho das matrizes de atualização de baixo posto é determinado pelo rank ou r. Um posto mais alto significa que o modelo possui mais parâmetros para treinar, mas também significa que o modelo tem mais capacidade de aprendizado. No exemplo a seguir, você vai direcionar as matrizes de query e value dos blocos de atenção. Outros parâmetros importantes para definir são lora_alpha (fator de escala), bias (se none, all ou apenas os parâmetros de viés do LoRA devem ser treinados) e modules_to_save (os módulos, além das camadas LoRA, que devem ser treinados e salvos). Todos esses parâmetros - e mais - podem ser encontrados no LoraConfig.
from peft import LoraConfig, get_peft_model

config = LoraConfig(
    r=16,
    lora_alpha=16,
    target_modules=["query", "value"],
    lora_dropout=0.1,
    bias="none",
    modules_to_save=["classifier"],
)
model = get_peft_model(model, config)
model.print_healthcheck()
Visão geral do benchmark
Inicialização
A inicialização dos pesos do LoRA é controlada pelo parâmetro init_lora_weights em LoraConfig. Por padrão, o PEFT inicializa os pesos do LoRA com Kaiming-uniform para o peso A e zeros para o peso B, resultando em uma transformação identidade (igual à implementação de referência).
Para camadas de transformers.Conv1D, como as projeções do GPT-2, use fan_in_fan_out=True porque seus pesos são armazenados como (in_features, out_features) em vez do layout do nn.Linear. Os inicializadores baseados em pesos suportados usam o layout Linear para a decomposição e restauram o layout de armazenamento ao atualizar os pesos base. O escalonamento "stable" do LoRA-GA também usa a dimensão de saída, independentemente do layout de armazenamento.
Também é possível passar init_lora_weights="gaussian". Como o nome sugere, isso inicializa o peso A com uma distribuição gaussiana e zeros para o peso B (é assim que o Diffusers inicializa os pesos do LoRA).
from peft import LoraConfig

config = LoraConfig(init_lora_weights="gaussian", ...)
Também há a opção de definir init_lora_weights=False, que é útil para depuração e testes. Este deve ser o único momento em que você usa essa opção. Ao escolher essa opção, os pesos do LoRA são inicializados de modo a não resultar em uma transformação identidade.
from peft import LoraConfig

config = LoraConfig(init_lora_weights=False, ...)Normalized Low-Rank Adaptation (NoRA) normaliza as matrizes de down-projection do LoRA. O PEFT aplica essa normalização apenas na inicialização, por meio de init_lora_weights="nora" em LoraConfig: ele normaliza as colunas do peso A do LoRA, inicializado aleatoriamente, e inicializa o peso B do LoRA como zero. Ambas as matrizes permanecem treináveis e os pesos base são mantidos inalterados.
Para uma camada linear, a atualização de peso do adaptador é $\Delta W = sBA$, onde tem a forma (r, in_features), tem a forma (out_features, r), e é o fator de escala do LoRA. O NoRA parte do peso A aleatório criado pela camada linear do LoRA e normaliza cada coluna ao longo da dimensão de rank:
Como B é zero, a atualização do peso do adaptador é zero antes do treinamento. Com bias="none" e lora_bias=False, o adaptador preserva inicialmente a saída do modelo base. NoRA não requer um conjunto de dados de calibração nem uma decomposição de pesos.
Para o NoRA, a configuração recomendada é
lora_alphaigual ar(uma proporção alpha/rank de 1:1), por exemplo,r=8, lora_alpha=8. Com o padrãouse_rslora=False, isso mantém um fator de escala de 1; ao habilitar o LoRA estabilizado por rank, ele muda paralora_alpha / sqrt(r).
O exemplo a seguir aplica NoRA a duas camadas lineares em um pequeno modelo do PyTorch:
from torch import nn

from peft import LoraConfig, get_peft_model

model = nn.Sequential(
    nn.Linear(32, 32),
    nn.ReLU(),
    nn.Linear(32, 16),
)

config = LoraConfig(
    r=8,
    lora_alpha=8,
    target_modules=["0", "2"],
    init_lora_weights="nora",
    bias="none",
    lora_bias=False,
    use_rslora=False,
)
model = get_peft_model(model, config)
model.print_healthcheck()
Para um modelo do Transformers, defina target_modules com os nomes das camadas lineares que você deseja adaptar, como ["q_proj", "v_proj"], quando esses nomes estiverem presentes no modelo.
O NoRA utiliza as APIs existentes de configuração, treinamento, salvamento e carregamento do LoRA, portanto não há uma classe NoraConfig ou NoraModel separada. Para as APIs compartilhadas de configuração e modelo, consulte LoraConfig e LoraModel.
O NoRA suporta módulos alvo torch.nn.Linear ou nn.Parameters passados diretamente com target_parameters. Não é suportado para embeddings, camadas conv, etc.
PiSSA inicializa o adaptador LoRA usando os valores singulares principais e os vetores singulares. Essa modificação simples permite que o PiSSA converja mais rapidamente do que o LoRA e, em última análise, alcance um desempenho superior. Além disso, o PiSSA reduz o erro de quantização em comparação com o QLoRA, levando a melhorias adicionais.
Configure o método de inicialização para “pissa”, que pode levar vários minutos para executar o SVD no modelo pré-treinado:
from peft import LoraConfig
config = LoraConfig(init_lora_weights="pissa", ...)
Alternativamente, execute o SVD rápido, que leva apenas alguns segundos. O número de iterações determina o equilíbrio entre o erro e o tempo de computação:
lora_config = LoraConfig(init_lora_weights="pissa_niter_[number of iters]", ...)Para instruções detalhadas sobre o uso do PiSSA, siga estas instruções.
MiCA (Minor Component Adaptation) é um complemento para o PiSSA: em vez de inicializar a partir dos componentes singulares principais, o MiCA utiliza os menores. Concretamente, com W = U Σ V^T, o MiCA define B = U[:, -r:] (os r vetores singulares à esquerda associados aos menores valores singulares) e A = 0. Durante o treinamento, apenas A é atualizado; B permanece congelado. A intuição é que as direções singulares menores são amplamente não utilizadas pela tarefa pré-treinada e, portanto, oferecem um subespaço mais “plástico” para injetar novo conhecimento, preservando ao mesmo tempo as capacidades pré-treinadas.
Como A == 0 na inicialização, a contribuição do adaptador B · A == 0 e a saída do modelo é preservada exatamente no passo 0 — não é necessário subtrair o residual do peso base (diferente do PiSSA). Como apenas A é treinável, a contagem de parâmetros treináveis para corresponder a r é aproximadamente metade da do LoRA.
from peft import LoraConfig
config = LoraConfig(init_lora_weights="mica", r=16, target_modules=["q_proj", "v_proj"], ...)
MiCA atualmente suporta os módulos alvo nn.Linear e nn.Embedding. O rank escolhido deve satisfazer r <= min(in_features, out_features) para camadas lineares e r <= min(num_embeddings, embedding_dim) para camadas de embedding. Para instruções detalhadas de uso, consulte estas instruções.
O MiCA é destinado principalmente ao pré-treinamento contínuo / pré-treinamento adaptado ao domínio. Nesse cenário, use o modelo base, e não um checkpoint ajustado para instruções ou chat, para a inicialização do SVD e o treinamento do MiCA. Após o treinamento, mergeie o adaptador nos pesos do modelo base e use o modelo base adaptado resultante como ponto de partida para o ajuste subsequente de instruções/chat.
CorDA constrói adaptadores LoRA conscientes da tarefa a partir de uma decomposição de pesos orientada pelo contexto da tarefa de baixo nível a ser aprendida (modo de pré-visualização de instrução, IPM) ou pelo conhecimento do mundo a ser mantido (modo de preservação de conhecimento, KPM). O KPM não apenas atinge um desempenho melhor que o LoRA em tarefas de ajuste fino, mas também mitiga o esquecimento catastrófico do conhecimento do mundo pré-treinado. Quando a preservação do conhecimento pré-treinado não é uma preocupação, o IPM é preferido, pois pode acelerar ainda mais a convergência e aprimorar o desempenho do ajuste fino.
Você precisa configurar o método de inicialização para “corda” e especificar o modo IPM ou KPM e o conjunto de dados para coletar as matrizes de covariância.
@torch.no_grad()
def run_model():
    # Assume `model` and `dataset` is in context...
    model.eval()
    for batch in dataset:
        model(**batch)


corda_config = CordaConfig(
    corda_method="kpm",
)
lora_config = LoraConfig(
    init_lora_weights="corda",
    corda_config=corda_config,
)
preprocess_corda(model, lora_config, run_model=run_model)
peft_model = get_peft_model(model, lora_config)
Para instruções detalhadas sobre o uso do CorDA, siga estas instruções.
Astra constrói adaptadores LoRA conscientes da tarefa a partir dos autovetores de cauda da matriz de covariância das ativações de saída do módulo, estimados a partir de um pequeno conjunto de dados de calibração da tarefa de destino. O peso pré-treinado é projetado no subespaço gerado pelos autovetores de cauda para inicializar o adaptador, o que restringe a atualização ao subespaço de ativação mais relevante para a tarefa de destino e acelera a convergência.
Você precisa configurar o método de inicialização para “astra”, definir explicitamente target_modules e fornecer o
conjunto de dados de calibração para coletar as matrizes de covariância.
@torch.no_grad()
def run_model():
    # Assume `model` and `dataset` is in context...
    model.eval()
    for batch in dataset:
        model(**batch)


from peft.tuners.lora import AstraConfig, preprocess_astra

astra_config = AstraConfig()
lora_config = LoraConfig(
    init_lora_weights="astra",
    target_modules=["q_proj", "v_proj"],
    astra_config=astra_config,
)
preprocess_astra(model, lora_config, run_model=run_model)
peft_model = get_peft_model(model, lora_config)
Para instruções detalhadas sobre o uso do Astra, siga estas instruções.
OLoRA utiliza a decomposição QR para inicializar os adaptadores LoRA. O OLoRA traduz os pesos base do modelo por um fator de suas decomposições QR, ou seja, ele altera os pesos antes de executar qualquer treinamento neles. Essa abordagem melhora significativamente a estabilidade, acelera a velocidade de convergência e, em última análise, alcança um desempenho superior.
Você só precisa passar uma opção adicional para usar OLoRA:
from peft import LoraConfig
config = LoraConfig(init_lora_weights="olora", ...)
Para um uso mais avançado, consulte nossa documentação.
EVA executa SVD nas ativações de entrada de cada camada e usa os vetores singulares à direita para inicializar os pesos do LoRA. Portanto, é um esquema de inicialização orientado por dados. Além disso, o EVA aloca adaptativamente os ranks entre as camadas com base na sua “razão de variância explicada” — uma métrica derivada da análise SVD.
Você pode usar o EVA definindo init_lora_weights="eva" e definindo EvaConfig em LoraConfig:
from peft import LoraConfig, EvaConfig
peft_config = LoraConfig(
    init_lora_weights = "eva",
    eva_config = EvaConfig(rho = 2.0),
    ...
)
O parâmetro rho (≥ 1.0) determina o quanto de redistribuição é permitido. Quando rho=1.0 e r=16, os adaptadores LoRA são limitados a exatamente 16 ranks, impedindo que qualquer redistribuição ocorra. Um valor recomendado para EVA com redistribuição é 2.0, o que significa que o rank máximo permitido para uma camada é 2r.
É recomendado executar a inicialização do EVA em um acelerador (por exemplo, GPU CUDA, XPU da Intel), pois é muito mais rápido. Para otimizar a quantidade de memória disponível para o EVA, você pode usar a flag low_cpu_mem_usage em get_peft_model():
peft_model = get_peft_model(model, peft_config, low_cpu_mem_usage=True)Em seguida, chame initialize_lora_eva_weights() para inicializar os pesos do EVA (na maioria dos casos, o dataloader usado para a inicialização do EVA pode ser o mesmo usado para o finetuning):
initialize_lora_eva_weights(peft_model, dataloader)
O EVA funciona imediatamente com bitsandbytes. Basta inicializar o modelo com quantization_config e chamar initialize_lora_eva_weights() como de costume.
Para mais instruções sobre o uso do EVA, consulte nossa documentação.
Ao quantizar o modelo base para o treinamento com QLoRA, considere usar a inicialização LoftQ, que demonstrou melhorar o desempenho ao treinar modelos quantizados. A ideia é que os pesos do LoRA sejam inicializados de modo a minimizar o erro de quantização. Para usar o LoftQ, siga estas instruções.
Saiba mais sobre como o PEFT funciona com quantização e como usar o LoftQ no guia Quantização.
Outra forma de inicializar o LoraConfig é com o método rank-stabilized LoRA (rsLoRA). A arquitetura LoRA escala cada adaptador durante cada passagem de frente por um escalar fixo, definido na inicialização e que depende do rank r. O escalar é dado por lora_alpha/r na implementação original, mas o rsLoRA usa lora_alpha/math.sqrt(r), o que estabiliza os adaptadores e aumenta o potencial de desempenho ao usar um r maior.
from peft import LoraConfig

config = LoraConfig(use_rslora=True, ...)
LoRA-GA (Low-Rank Adaptation with Gradient Approximation) inicializa os pesos do adaptador executando SVD em gradientes estimados, de modo que os pesos se alinham mais de perto ao full-finetuning para uma convergência mais rápida.
Este método requer uma função de inicialização para estimar os gradientes antes de iniciar o treinamento real:
from peft.tuners.lora import preprocess_loraga

def train_step():
    """Run forward and backward passes for gradient estimation."""
    dataloader_iter = iter(grad_dataloader)
    for _ in range(N):
        batch = next(dataloader_iter)
        batch = {k: v.to(device) for k, v in batch.items()}
        outputs = model(**batch)
        loss = outputs.loss
        loss.backward()

preprocess_loraga(model, lora_config, train_step)
Dicas de uso
Estimação de Gradiente: o LoRA-GA requer uma fase de estimação de gradiente antes da inicialização do modelo. Use
preprocess_loraga()com um callbacktrain_steppara calcular os gradientes sobre um pequeno número de lotes de treinamento (tipicamente 64-128 lotes).Estratégias de inicialização: o LoRA-GA suporta quatro estratégias de direção (
direction):"ArBr","A2rBr","ArB2r"(padrão) e"random", e quatro estratégias de escala (scale):"stable"(padrão),"weight_svd","gd_scale"e"unit". A combinação padrão oferece o melhor equilíbrio entre velocidade de convergência e estabilidade.Modificação dos pesos base: Diferentemente do LoRA padrão, o LoRA-GA modifica os pesos do modelo base durante a inicialização, subtraindo uma versão escalonada da aproximação de baixo posto. Isso permite um melhor alinhamento com os gradientes do fine-tuning completo. Como os pesos base são modificados, use
save_pretrained()com o argumentosave_embedding_layersou passepath_initial_model_for_weight_conversion.Sobrecarga computacional: A estimativa do gradiente adiciona uma pequena sobrecarga durante a inicialização (tipicamente 1-2 minutos para 64 lotes), mas isso é rapidamente amortizado pela convergência mais rápida durante o treinamento.
Compatibilidade: LoRA-GA requer pesos em precisão completa e não suporta modelos quantizados. Pode ser combinado com outras variantes de LoRA, como DoRA.
Treinamento
Esta seção mostra como lidar com cenários de treinamento mais complexos, em vez de apenas aplicar um adaptador de baixo rank ao modelo e fornecer dados.
Treinamento no estilo QLoRA
As configurações padrão de LoRA no PEFT adicionam pesos treináveis às camadas de query e value de cada bloco de atenção. Mas o QLoRA, que adiciona pesos treináveis a todas as camadas lineares de um modelo transformer, pode fornecer desempenho igual ao de um modelo totalmente ajustado. Para aplicar LoRA a todas as camadas lineares, como no QLoRA, defina target_modules="all-linear" (mais fácil do que especificar módulos individuais por nome, o que pode variar dependendo da arquitetura).
config = LoraConfig(target_modules="all-linear", ...)Para mais informações sobre como aplicar quantização a adaptadores PEFT, consulte o guia de quantização.
Replicação de camadas eficiente em memória com LoRA
Uma abordagem usada para melhorar o desempenho de modelos consiste em expandir um modelo duplicando camadas para construir um modelo maior a partir de um modelo pré-treinado de um determinado tamanho. Por exemplo, aumentar um modelo de 7B para um modelo de 10B, conforme descrito no paper SOLAR. O PEFT LoRA suporta esse tipo de expansão de forma eficiente em memória, permitindo o ajuste fino posterior usando adaptadores LoRA anexados às camadas após a replicação. As camadas replicadas não consomem memória adicional, pois compartilham os pesos subjacentes, de modo que a única memória extra necessária é a dos pesos dos adaptadores. Para usar esse recurso, você deve criar uma configuração com o argumento layer_replication.
config = LoraConfig(layer_replication=[[0,4], [2,5]], ...)Assumindo que o modelo original tivesse 5 camadas [0, 1, 2 ,3, 4], isso criaria um modelo com 7 camadas organizadas como [0, 1, 2, 3, 2, 3, 4]. Isso segue a convenção de mesclagem pass through do mergekit, na qual sequências de camadas especificadas como tuplas com início inclusivo e fim exclusivo são empilhadas para construir o modelo final. Cada camada no modelo final recebe seu próprio conjunto distinto de adaptadores LoRA.
Fewshot-Metamath-OrcaVicuna-Mistral-10B é um exemplo de modelo treinado usando esse método no Mistral-7B expandido para 10B. O adapter_config.json mostra uma configuração de adaptador LoRA de exemplo que aplica esse método para fine-tuning.
Controle fino sobre ranks e alpha (escala)
Por padrão, todas as camadas alvo do LoRA terão o mesmo rank r e o mesmo lora_alpha (que determina o escalonamento do LoRA), conforme especificado no LoraConfig. Em alguns casos, no entanto, você pode querer indicar valores diferentes para camadas diferentes. Isso é possível passando os argumentos rank_pattern e alpha_pattern para LoraConfig. Esses argumentos devem ser dicionários com a chave sendo o nome da camada e o valor sendo o valor de rank/alpha. As chaves podem ser expressões regulares (regex). Todas as camadas LoRA que não forem explicitamente mencionadas em rank_pattern e alpha_pattern assumirão os valores padrão de r e lora_alpha.
Para dar um exemplo, vamos supor que temos um modelo com a seguinte estrutura:
>>> print(model)
Outer(
  (foo): Linear(...)
  (module): Middle(
    (foo): Linear(...)
    (foobar): Linear(...)
    (module): Inner(
      (foo): Linear(...)
      (barfoo): Linear(...)
    )
  )
)
rank_pattern={"foo": 42}corresponderá a todas as 3 camadasfoo. Nemfoobarnembarfoosão correspondidos.rank_pattern={"^foo": 42}corresponderá apenas à camadafoodo modelo, mas nem amodule.foonem amodule.module.foo. Isso ocorre porque^significa “início da string” ao usar expressões regulares, e apenasfoocomeça com"foo"; os outros nomes de camada possuem prefixos.rank_pattern={"^module.foo": 42}corresponde apenas amodule.foo, mas não amodule.module.foo, pelo mesmo motivo.rank_pattern={"module.foo": 42}corresponde tanto amodule.fooquanto amodule.module.foo, mas não afoo.rank_pattern={"^foo": 42, "^module.module.foo": 55}corresponde afooemodule.module.foo, respectivamente, mas não amodule.foo.- Não é necessário indicar
$para marcar o fim da correspondência, pois isso é adicionado automaticamente pelo PEFT.
A mesma lógica se aplica a alpha_pattern. Se você tiver dúvidas, não tente ser criativo com expressões regulares — basta passar o nome completo de cada módulo com um rank/alpha diferente, precedido pelo prefixo ^, e estará tudo certo.
Detectar automaticamente módulos de destino viáveis
peft.helpers.KappaTuneSelector implementa a estratégia de seleção de alvos baseada no número de condicional descrita no artigo KappaTune. Ela varre todos os módulos nn.Linear e, para modelos em que os pesos de especialistas MoE são armazenados como tensores nn.Parameter 3D fundidos (por exemplo, Llama-4, Qwen3-MoE), também esses parâmetros, calcula o número de condicional da matriz κ = σ_max / σ_min para cada um e seleciona as camadas mais isotrópicas (menor κ). Essas camadas isotrópicas servem como candidatos ideais para fine-tuning, pois sua natureza de alta entropia permite que absorvam novas informações com mais facilidade, mantendo as camadas especializadas e anisotrópicas intactas para mitigar o esquecimento catastrófico durante o aprendizado contínuo.
Use peft.helpers.find_kappa_target_modules() como uma linha única para obter os target_modules ideais para o LoraConfig:
from peft import LoraConfig, get_peft_model
from peft.helpers import find_kappa_target_modules

model = AutoModelForCausalLM.from_pretrained("mistralai/Mixtral-8x7B-Instruct-v0.1")

targets = find_kappa_target_modules(model, top_p=0.2)
config = LoraConfig(
    target_modules=targets["target_modules"],
    target_parameters=targets["target_parameters"] if stable_modules_dic["target_parameters"] else None,
    r=64,
    lora_alpha=32,
    task_type="CAUSAL_LM",
)
peft_model = get_peft_model(model, config)
Veja um exemplo completo aqui.
Direcionando-se diretamente para nn.Parameter
Em geral, você deve usar target_modules para direcionar o módulo (por exemplo, nn.Linear). No entanto, em algumas circunstâncias, isso não é possível. Por exemplo, em muitas camadas de mixture of expert (MoE) no HF Transformers, em vez de usar nn.Linear, um nn.Parameter é utilizado. O PEFT normalmente sobrescreve o método forward para LoRA, mas para nn.Parameter, não há nenhum. Portanto, para aplicar LoRA a esse parâmetro, ele precisa ser direcionado com target_parameters. Como exemplo, para Llama4, você pode passar: target_parameters=['feed_forward.experts.gate_up_proj', 'feed_forward.experts.down_proj].
Observe que, ao direcionar parâmetros de especialistas, o PEFT pode adicionar uma sobrecarga de tempo de execução considerável. A razão é que o PEFT sempre materializa a contribuição do LoRA para cada especialista, mesmo que apenas uma pequena quantidade de especialistas seja necessária. Durante o treinamento, isso é menos relevante, pois, ao longo da sequência, tipicamente uma grande fração dos especialistas é ativada pelo menos uma vez. No entanto, durante a inferência, normalmente um cache KV é usado e, portanto, precisamos calcular apenas o último token, o que significa que apenas uma pequena quantidade de especialistas é ativada. Portanto, usar LoRA em camadas MoE pode resultar em um atraso considerável no tempo de inferência. A recomendação, portanto, é mesclar os pesos (model.merge_adapter() ou model = model.merge_and_unload()). Isso remove a sobrecarga do PEFT.
Uma investigação mais detalhada sobre essa questão pode ser encontrada neste pull request sobre otimização de MoE.
Observações
- No momento, este argumento permite direcionar
nn.Parameters de 2 ou 3 dimensões. Assume-se que, no caso de um parâmetro de 3 dimensões, a dimensão 0 é a dimensão do especialista. - Vários adaptadores LoRA (adicionados via
model.add_adapteroumodel.load_adapter) que usamtarget_parameterssão suportados, mas todos eles devem visar o mesmo conjunto de parâmetros.
Parâmetros de especialistas MoE e vLLM
Alguns modelos MoE em Transformers armazenam os pesos dos especialistas como tensores nn.Parameter (frequentemente 3D), e não como módulos nn.Linear.
Para aplicar LoRA a esses especialistas, use target_parameters e defina um rank por camada com rank_pattern:
num_experts = getattr(model.config, "num_local_experts", None) or model.config.num_experts
effective_r = max(1, r // num_experts)
config = LoraConfig(
    r=r,
    lora_alpha=32,
    target_modules=["q_proj", "v_proj"],
    target_parameters=[
        # Mixtral / Qwen3-MoE / GPT-OSS
        "mlp.experts.gate_up_proj",
        "mlp.experts.down_proj",
        # Llama4
        # "feed_forward.experts.gate_up_proj",
        # "feed_forward.experts.down_proj",
    ],
    rank_pattern={
        "experts.gate_up_proj": effective_r,
        "experts.down_proj": effective_r,
    },
)
Isso mantém o orçamento total de parâmetros do LoRA semelhante ao das camadas densas (veja LoRA Without Regret de Schulman et. al.). Os módulos não especialistas usam o rank padrão r.
A inferência acelerada com o modelo ajustado é possível com, por exemplo, vLLM, que suporta camadas de especialistas MoE fundidas desde a v0.11.2.
Treine tokens de forma eficiente junto com o LoRA
Os adaptadores PEFT LoRA suportam a adição de novos tokens com o parâmetro trainable_token_indices. Isso permite o ajuste de outros tokens em conjunto com o fine-tuning de camadas específicas. Apenas os tokens especificados são treinados e todos os outros permanecem inalterados. Isso economiza memória e não descarta o contexto aprendido dos embeddings de tokens existentes, ao contrário do treinamento de toda a matriz de embeddings. Internamente, este método utiliza a camada de TrainableTokensModel.
# for layer 'embed_tokens'
config = LoraConfig(trainable_token_indices=[idx_1, idx_2, ...], ...)

# specific embedding layer
config = LoraConfig(trainable_token_indices={'emb_tokens': [idx_1, idx_2, ...]}, ...)
No trecho abaixo, mostramos como adicionar novos tokens ao modelo e como treiná-lo junto com as outras camadas do modelo.
from transformers import AutoTokenizer, AutoModelForCausalLM
from peft import get_peft_model, LoraConfig

base_model = AutoModelForCausalLM.from_pretrained("mistralai/Mistral-7B-v0.1")
tokenizer = AutoTokenizer.from_pretrained("mistralai/Mistral-7B-v0.1")

# we define our new tokens and add them to the tokenizer as special tokens
special_tokens = ['<|start_think|>', '<|stop_think|>']
tokenizer.add_special_tokens({'additional_special_tokens': special_tokens})

# make room for new tokens in the embedding matrix if it isn't big enough already
base_model.resize_token_embeddings(max(len(tokenizer), base_model.model.embed_tokens.num_embeddings))

# typical LoRA config with `trainable_token_indices` targeting embedding layer `embed_tokens`
# and specifically our new tokens we just added
lora_config = LoraConfig(
    target_modules='all-linear',
    trainable_token_indices={'embed_tokens': tokenizer.convert_tokens_to_ids(special_tokens)},
)
peft_model = get_peft_model(base_model, lora_config)

# proceed to train the model like normal
[...]
Os pesos dos tokens são salvos como parte do dicionário de estado do adaptador, junto com os pesos do LoRA. O ajuste fino completo e o salvamento da matriz de incorporação teriam armazenado um arquivo muito maior.
Para dar uma noção de quanto VRAM pode ser economizado, uma comparação rudimentar do exemplo acima foi feita entre treinar a matriz de incorporação totalmente (modules_to_save=["embed_tokens"]), usar um LoRA para a matriz de incorporação (target_modules=[..., "embed_tokens"], rank 32) e tokens treináveis (trainable_token_indices=[...], 6 tokens):
| Tokens treináveis | LoRA | Ajuste fino completo | |
|---|---|---|---|
| VRAM | 15,562 MB | 15,581MB | ~16.500MB |
| Influência | 6 tokens | todos os tokens | todos os tokens |
Vinculação de pesos
Muitos LMs causais usam weight tying, no qual dois ou mais pesos compartilham os mesmos parâmetros subjacentes. No caso mais comum, os pesos de incorporação de entrada (embed_tokens) e os pesos de projeção de saída (lm_head) compartilham o mesmo tensor. Isso ocorre porque reduz o número de parâmetros e geralmente preserva a qualidade do modelo.
Nem sempre é óbvio como o PEFT lida com esses pesos vinculados quando eles são alvo de ajuste fino. Para o LoRA, o ensure_weight_tying no LoraConfig controla se o PEFT deve manter explicitamente vinculadas as atualizações do lado do adaptador para aquelas camadas. Na prática, isso pode afetar modules_to_save, target_modules e trainable_token_indices. Observe que essa lógica depende parcialmente de convenção no que diz respeito ao nome das camadas ("embed_tokens", "lm_head") e o funcionamento adequado não pode ser garantido se essas convenções não forem usadas.
As tabelas abaixo resumem o comportamento esperado.
modules_to_save
| Pesos do modelo base vinculados | ensure_weight_tying | Formato de LoraConfig | Comportamento |
|---|---|---|---|
| Não | False | modules_to_save=["embed_tokens"] ou ["lm_head"] | Adicione ModulesToSaveWrapper apenas na camada selecionada |
| Não | True | modules_to_save=["embed_tokens"] ou ["lm_head"] | Emita um aviso e, em seguida, adicione ModulesToSaveWrapper apenas na camada selecionada |
| Sim | False | modules_to_save=["embed_tokens"] ou ["lm_head"] | Tratar como separados |
| Sim | True | modules_to_save=["embed_tokens"] ou ["lm_head"] | Envolver camadas vinculadas e manter os wrappers vinculados |
| Não | False | modules_to_save=["embed_tokens", "lm_head"] | Tratar como separados |
| Não | True | modules_to_save=["embed_tokens", "lm_head"] | Avisar e, em seguida, tratar como separados |
| Sim | False | modules_to_save=["embed_tokens", "lm_head"] | Avisar e, em seguida, tratar como separados |
| Sim | True | modules_to_save=["embed_tokens", "lm_head"] | Mantenha os ModulesToSaveWrappers vinculados |
target_modules
| Pesos do modelo base vinculados | ensure_weight_tying | Formato de LoraConfig | Comportamento |
|---|---|---|---|
| Não | False | target_modules=["embed_tokens"] ou ["lm_head"] | Adicionar LoRA apenas na camada selecionada |
| Não | True | target_modules=["embed_tokens"] ou ["lm_head"] | Avisar e, em seguida, adicionar LoRA apenas na camada selecionada |
| Sim | False | target_modules=["embed_tokens"] ou ["lm_head"] | Tratar como separados |
| Sim | True | target_modules=["embed_tokens"] ou ["lm_head"] | Mantenha os adaptadores LoRA vinculados |
| Não | False | target_modules=["embed_tokens", "lm_head"] | Tratar como separados |
| Não | True | target_modules=["embed_tokens", "lm_head"] | Avisar e, em seguida, tratar como separados |
| Sim | False | target_modules=["embed_tokens", "lm_head"] | Avisar e, em seguida, tratar como separados |
| Sim | True | target_modules=["embed_tokens", "lm_head"] | Mantenha os adaptadores LoRA vinculados |
trainable_token_indices
Para tokens treináveis, temos a complicação adicional de que, mesmo que a cabeça do LM e os embeddings estejam vinculados, como usuário, posso querer fazer o ajuste fino de tokens diferentes neles. Na tabela de exemplo abaixo, diferenciamos, portanto, entre fazer o ajuste fino dos mesmos tokens e fazer o ajuste fino de tokens diferentes.
| Pesos do modelo base vinculados | ensure_weight_tying | Formato de LoraConfig | Comportamento |
|---|---|---|---|
| Não | False | trainable_token_indices=[1, 2, 3] | Tokens treináveis apenas em embeddings |
| Não | True | trainable_token_indices=[1, 2, 3] | Avisar, então tokens treináveis apenas em incorporações |
| Sim | False | trainable_token_indices=[1, 2, 3] | Tokens treináveis vinculados |
| Sim | True | trainable_token_indices=[1, 2, 3] | Tokens treináveis vinculados |
| Não | False | trainable_token_indices={"lm_head": [1, 2], "embed_tokens": [1, 2]} | Tratar como separados |
| Não | True | trainable_token_indices={"lm_head": [1, 2], "embed_tokens": [1, 2]} | Avisar e, em seguida, tratar como separados |
| Sim | False | trainable_token_indices={"lm_head": [1, 2], "embed_tokens": [1, 2]} | Tokens treináveis vinculados |
| Sim | True | trainable_token_indices={"lm_head": [1, 2], "embed_tokens": [1, 2]} | Tokens treináveis vinculados |
| Não | False | trainable_token_indices={"lm_head": [1, 2], "embed_tokens": [3, 4]} | Tratar como separados |
| Não | True | trainable_token_indices={"lm_head": [1, 2], "embed_tokens": [3, 4]} | Avisar e, em seguida, tratar como separados |
| Sim | False | trainable_token_indices={"lm_head": [1, 2], "embed_tokens": [3, 4]} | Tratar como separados |
| Sim | True | trainable_token_indices={"lm_head": [1, 2], "embed_tokens": [3, 4]} | Erro |
Para os usuários, isso significa:
- Em geral, se você deseja ajustar pesos que estão vinculados e quer mantê-los vinculados, passe
ensure_weight_tying=True. - Se os pesos do seu modelo base não estiverem vinculados,
ensure_weight_tying=Truenão pode forçar a vinculação e apenas emite um aviso. - Para
trainable_token_indices, as camadas vinculadas devem usar os mesmos índices de tokens quandoensure_weight_tying=True.
Otimizadores
O treinamento com LoRA pode incluir, opcionalmente, otimizadores de uso especial. Atualmente, o PEFT suporta LoRA-FA, LoRA+ e LoRA com pré-condicionamento riemanniano.
Otimizador LoRA-FA
O treinamento com LoRA pode ser mais eficaz e eficiente usando LoRA-FA, conforme descrito em LoRA-FA. O LoRA-FA reduz o consumo de memória de ativação ao fixar a matriz A e ajustar apenas a matriz B. Durante o treinamento, o gradiente de B é otimizado para aproximar o gradiente do ajuste fino de parâmetros completos. Além disso, o consumo de memória do LoRA-FA não é sensível ao rank (uma vez que ele elimina a ativação de $A$), portanto, é possível melhorar o desempenho aumentando o lora rank sem aumentar o consumo de memória.
from peft import LoraConfig, get_peft_model
from peft.optimizers import create_lorafa_optimizer
from transformers import Trainer, get_cosine_schedule_with_warmup

base_model = AutoModelForCausalLM.from_pretrained("meta-llama/Meta-Llama-3-8B-Instruct")

config = LoraConfig(...)
model = get_peft_model(base_model, config)

optimizer = create_lorafa_optimizer(
    model=model,
    r=128,
    lora_alpha=32,
    lr=7e-5,
)

scheduler = get_cosine_schedule_with_warmup(
    optimizer,
    num_warmup_steps=100,
    num_training_steps=1000,
)

trainer = Trainer(
    ...,
    optimizers=(optimizer, scheduler),
)
LoRA+ otimizado
O treinamento de LoRA pode ser otimizado usando LoRA+, que utiliza taxas de aprendizado diferentes para as matrizes de adaptador A e B, demonstrando um aumento de até 2x na velocidade de ajuste fino e de 1-2% no desempenho.
from peft import LoraConfig, get_peft_model
from peft.optimizers import create_loraplus_optimizer
from transformers import Trainer
import bitsandbytes as bnb

base_model = ...
config = LoraConfig(...)
model = get_peft_model(base_model, config)

optimizer = create_loraplus_optimizer(
    model=model,
    optimizer_cls=bnb.optim.Adam8bit,
    lr=5e-5,
    loraplus_lr_ratio=16,
)
scheduler = None

...
trainer = Trainer(
    ...,
    optimizers=(optimizer, scheduler),
)
LoRA pré-condicionado riemanniano
O treinamento de LoRA pode ser aprimorado com um pré-condicionador riemanniano, conforme descrito em Riemannian Preconditioned LoRA. Em cada passo do otimizador, os gradientes das matrizes LoRA e são multiplicados por um pré-condicionador que reescala o gradiente euclidiano em direção à direção riemanniana (gradiente escalonado) na variedade de matrizes de baixo posto, o que melhora o condicionamento da atualização e pode melhorar a convergência. Como o pré-condicionador é $r \times r$, sua sobrecarga de memória e tempo de execução é pequena em relação ao posto do LoRA. create_riemannian_optimizer envolve qualquer classe de otimizador base (por exemplo, torch.optim.AdamW ou torch.optim.SGD): os parâmetros não-LoRA são atualizados pelo otimizador base sem alterações, e apenas nn.Linear-camadas LoRA com formatolora_A / lora_B) são pré-condicionados.
from peft import LoraConfig, get_peft_model
from peft.optimizers import create_riemannian_optimizer
from transformers import Trainer, get_cosine_schedule_with_warmup
import torch

base_model = AutoModelForCausalLM.from_pretrained("meta-llama/Meta-Llama-3-8B-Instruct")

config = LoraConfig(...)
model = get_peft_model(base_model, config)

optimizer = create_riemannian_optimizer(
    model=model,
    optimizer_cls=torch.optim.AdamW,
    lr=5e-5,
    reg=1e-2,
)

scheduler = get_cosine_schedule_with_warmup(
    optimizer,
    num_warmup_steps=100,
    num_training_steps=1000,
)

trainer = Trainer(
    ...,
    optimizers=(optimizer, scheduler),
)
reg é um termo de amortecimento adicionado à diagonal da matriz antes da inversão; ele estabiliza o pré-condicionador quando um fator LoRA é (quase) de posto deficiente.
Treinamento Pós
Esta seção mostra possíveis métodos de pós-processamento para adaptadores treinados.
Mesclar os pesos do LoRA no modelo base
Embora o LoRA seja significativamente menor e mais rápido de treinar, você pode encontrar problemas de latência durante a inferência devido ao carregamento separado do modelo base e do adaptador LoRA. Para eliminar a latência, use a função merge_and_unload() para mesclar os pesos do adaptador com o modelo base. Isso permite que você use o novo modelo mesclado como um modelo independente. A função merge_and_unload() não mantém os pesos do adaptador na memória.
Abaixo está um diagrama que explica a intuição por trás da mesclagem de adaptadores LoRA:

Mostramos nos trechos abaixo como executar isso usando PEFT.
from transformers import AutoModelForCausalLM
from peft import PeftModel

base_model = AutoModelForCausalLM.from_pretrained("mistralai/Mistral-7B-v0.1")
peft_model_id = "alignment-handbook/zephyr-7b-sft-lora"
model = PeftModel.from_pretrained(base_model, peft_model_id)
model = model.merge_and_unload()
É importante atribuir o modelo retornado a uma variável e usá-lo, pois merge_and_unload() não é uma operação in-place. Se você precisar manter uma cópia dos pesos para poder desintegrar o adaptador posteriormente ou excluir e carregar outros diferentes, você deve usar a função merge_adapter() em vez disso. Agora você tem a opção de usar unmerge_adapter() para retornar o modelo base.
from transformers import AutoModelForCausalLM
from peft import PeftModel

base_model = AutoModelForCausalLM.from_pretrained("mistralai/Mistral-7B-v0.1")
peft_model_id = "alignment-handbook/zephyr-7b-sft-lora"
model = PeftModel.from_pretrained(base_model, peft_model_id)
model.merge_adapter()

# unmerge the LoRA layers from the base model
model.unmerge_adapter()
Em um modelo quantizado, o desmerge não é exato: o merge re-quantiza o peso base, e ciclos repetidos de merge e desmerge podem acumular erro de arredondamento. Consulte Merging adapters into quantized weights.
Se vários adaptadores estiverem ativos e apenas alguns deles forem mesclados, os adaptadores que não forem mesclados não serão aplicados silenciosamente. Esse comportamento mudará no PEFT v1.0. Consulte Mesclando apenas alguns dos adaptadores ativos.
A função add_weighted_adapter() é útil para mesclar vários LoRAs em um novo adaptador com base em um esquema de ponderação fornecido pelo usuário no parâmetro weights. Abaixo está um exemplo de ponta a ponta.
Primeiro, carregue o modelo base:
from transformers import AutoModelForCausalLM
from peft import PeftModel
import torch

base_model = AutoModelForCausalLM.from_pretrained(
    "mistralai/Mistral-7B-v0.1", dtype=torch.float16, device_map="auto"
)
Em seguida, carregamos o primeiro adaptador:
peft_model_id = "alignment-handbook/zephyr-7b-sft-lora"
model = PeftModel.from_pretrained(base_model, peft_model_id, adapter_name="sft")
Em seguida, carregue um adaptador diferente e combine-o com o primeiro:
weighted_adapter_name = "sft-dpo"
model.load_adapter("alignment-handbook/zephyr-7b-dpo-lora", adapter_name="dpo")
model.add_weighted_adapter(
    adapters=["sft", "dpo"],
    weights=[0.7, 0.3],
    adapter_name=weighted_adapter_name,
    combination_type="linear"
)
model.set_adapter(weighted_adapter_name)
Existem vários métodos suportados para
combination_type. Consulte a documentação para mais detalhes. Observe que “svd” comocombination_typenão é suportado ao usartorch.float16outorch.bfloat16como tipo de dados.
Agora, execute a inferência:
device = torch.accelerator.current_accelerator().type if hasattr(torch, "accelerator") else "cuda"

tokenizer = AutoTokenizer.from_pretrained("mistralai/Mistral-7B-v0.1")

prompt = "Hey, are you conscious? Can you talk to me?"
inputs = tokenizer(prompt, return_tensors="pt")
inputs = {k: v.to(device) for k, v in inputs.items()}

with torch.no_grad():
    generate_ids = model.generate(**inputs, max_length=30)
outputs = tokenizer.batch_decode(generate_ids, skip_special_tokens=True, clean_up_tokenization_spaces=False)[0]
print(outputs)
Recuperando o desempenho do modelo base por meio da redução da dimensão do intruso
O artigo LoRA vs Full Fine-tuning: An Illusion of Equivalence argumenta que o treinamento com LoRA introduz dimensões extras nos pesos que têm muito pouco em comum com os pesos já aprendidos e levam ao esquecimento de informações já aprendidas. O PEFT implementa a mitigação sugerida em peft.tuners.lora.intruders.reduce_intruder_dimension().
A mitigação utilizará um modelo PEFT com um LoRA carregado e criará um novo adaptador modificado que será carregado junto com o adaptador existente e se tornará o adaptador ativo.
Exemplo de uso:
from peft.tuners.lora.intruders import reduce_intruder_dimension

peft_model = AutoPeftModelForCausalLM.from_pretrained('hubnemo/llama-3.2b-metamathqa-lora64')

reduce_intruder_dimension(
    peft_model,
    mitigation_lambda=0.75,
)

peft_model.generate(...)
Existem alguns hiperparâmetros que podem ser usados para ajustar a eficácia da mitigação, mas, como evidenciado na Figura 8 do artigo, sempre haverá um compromisso entre a precisão da tarefa aprendida pelo adaptador e o esquecimento do conhecimento do modelo base. A mitigação removerá informações do adaptador para reduzir o impacto no esquecimento de conhecimentos anteriores, mas isso também significa que algumas informações sobre a tarefa aprendidas pelo adaptador também serão perdidas.
Embora os padrões sejam configurados para oferecer um bom equilíbrio entre os dois fatores, não há garantia de que eles se mantenham adequados para o seu adaptador, o seu modelo e os seus dados; portanto, é recomendável ter um benchmark pronto para medir o efeito.
Carregar adaptadores
Adapters podem ser carregados em um modelo pré-treinado com load_adapter(), o que é útil para testar diferentes adapters cujos pesos não foram mesclados. Defina os pesos do adapter ativo com a função set_adapter().
from transformers import AutoModelForCausalLM
from peft import PeftModel

base_model = AutoModelForCausalLM.from_pretrained("mistralai/Mistral-7B-v0.1")
peft_model_id = "alignment-handbook/zephyr-7b-sft-lora"
model = PeftModel.from_pretrained(base_model, peft_model_id)

# load different adapter
model.load_adapter("alignment-handbook/zephyr-7b-dpo-lora", adapter_name="dpo")

# set adapter as active
model.set_adapter("dpo")
Para retornar o modelo base, você pode usar unload() para descarregar todos os módulos LoRA ou delete_adapter() para excluir o adaptador por completo. unload() não é uma operação in-place; lembre-se de atribuir o modelo retornado a uma variável e usá-lo.
# unload adapter
model = model.unload()

# delete adapter
model.delete_adapter("dpo")
Paralelismo de Tensors
O LoRA oferece suporte a Tensor Parallelism (TP) conforme fornecido pelo Transformers. Quando um modelo base é carregado com um tp_plan, o PEFT detecta automaticamente a configuração de TP de cada módulo alvo e adiciona os hooks apropriados aos pesos do adaptador LoRA para que eles participem corretamente do cálculo tensor-parallel.
O suporte a Tensor Parallelism para LoRA requer
transformers >= 5.4.0. A API de Tensor Parallelism baseada em DTensor requerpeft >= 0.21.1etransformers >= 5.17.0.
O uso é idêntico ao fluxo de trabalho padrão do LoRA — basta carregar o modelo base com um tp_plan antes de envolvê-lo com o PEFT:
from transformers import AutoModelForCausalLM
from peft import get_peft_model, LoraConfig

model = AutoModelForCausalLM.from_pretrained("meta-llama/Llama-3.1-8B", tp_plan="auto")
lora_config = LoraConfig(r=16, target_modules=["q_proj", "v_proj"])
model = get_peft_model(model, lora_config)
Salvar e carregar funcionam normalmente via save_pretrained / from_pretrained. O PEFT reúne os pesos do adaptador fragmentados de volta em tensores completos antes de salvar, de modo que os checkpoints são portáveis e independentes do número de dispositivos usados durante o treinamento.
Se você aplicar paralelismo de tensor sem um plano de TP, por exemplo, com parallelize_module do PyTorch, o PEFT dimensiona os pesos LoRA de um nn.Linear particionado para o tamanho do shard local se a malha de dispositivos do peso tiver uma dimensão nomeada "tp", e para a forma completa da camada caso contrário (como no FSDP2). O PEFT não adiciona hooks de TP a esses pesos LoRA nem os agrega ao salvar. Se a dimensão da sua malha de TP tiver um nome diferente, adicione-a antes de criar o modelo PEFT:
from peft.utils.integrations import TpMeshDimRegistry

TpMeshDimRegistry.register("tp_dim")
Inferência
Esta seção apresenta o que você pode fazer durante o tempo de inferência com LoRA, como desacoplar o adaptador.
LoRA ativado (aLoRA)
Activated LoRA (aLoRA) é uma arquitetura de adaptador de baixo rank para LMs causais que reutiliza o cache KV do modelo base existente para uma inferência mais eficiente. Essa abordagem é mais adequada para pipelines de inferência que dependem do modelo base para a maioria das tarefas/gerações, mas usam adaptador(es) aLoRA para executar tarefa(s) especializada(s) dentro da cadeia. Por exemplo, verificar ou corrigir as saídas geradas pelo modelo base. Nesses cenários, os tempos de inferência podem ser acelerados em uma ordem de grandeza ou mais. Para mais informações sobre aLoRA e muitos casos de uso de exemplo, veja o paper do aLoRA.
Essa técnica procura a última ocorrência de uma sequência de invocação (alora_invocation_tokens) em cada entrada (que pode ter apenas 1 token). Ela ativa os pesos do adaptador nos tokens a partir do início da sequência de invocação. Qualquer entrada após a sequência de invocação também é adaptada, e todos os tokens gerados usarão os pesos adaptados. Os pesos nos tokens anteriores são deixados sem adaptação, tornando o cache desses tokens intercambiável com o cache do modelo base devido à máscara de atenção causal nos LMs causais. O uso é muito semelhante ao do LoRA padrão. A principal diferença é que a sequência de invocação deve ser especificada quando o adaptador é criado:
from peft import LoraConfig

config = LoraConfig(alora_invocation_tokens=alora_invocation_tokens, task_type="CAUSAL_LM", ...)
alora_invocation_tokens` é uma lista de ids de tokens inteiros. Dada uma string de invocação desejada, isso pode ser obtido como:
invocation_string = "placeholder"
alora_invocation_tokens = tokenizer.encode(invocation_string, add_special_tokens=False).
O tokenizer é o tokenizer do modelo base. Use add_special_tokens=False para evitar a adição dos tokens SOS/EOS na nossa string de busca (o que provavelmente causará a falha da busca).
Observações
- aLoRA é suportado apenas para tarefas de
task_type=CAUSAL_LMdevido ao seu foco na reutilização de cache. - Como os pesos são adaptados em menos tokens, muitas vezes (nem sempre) o aLoRA requer um rank (
r) maior do que o LoRA.r=32pode ser um bom ponto de partida. - Os pesos do aLoRA não podem ser mesclados ao modelo base por definição, pois os pesos do adaptador são aplicados seletivamente a um subconjunto de tokens. Tentativas de mesclagem resultarão em erros.
- O beam search ainda não é suportado.
- Em geral, não é recomendado adicionar novos tokens ao tokenizer que não estejam presentes no modelo base. Isso pode complicar o caso de uso em que o modelo base e o modelo adaptador operam em contextos sobrepostos. Você pode contornar isso adicionando tokens treináveis ao modelo base antes de treinar o adaptador.
Escolha da sequência de invocação e do design do SFT
Você deve adicionar a sequência alora_invocation_tokens, pois ela não é adicionada automaticamente. Recomendamos ativar os pesos do adaptador precocemente (no início de qualquer prompt específico do adaptador), mas após qualquer entrada longa, para maximizar o desempenho do modelo sem comprometer a reutilização do cache. Como em qualquer modelo, o formato deve ser consistente entre o treinamento e o teste.
Considere o exemplo a seguir, em que o modelo base possui um modelo de chat e o objetivo é treinar o adaptador para gerar uma saída desejada.
- Opção 1: Se não houver um prompt específico para a tarefa, ou seja, se a entrada for um histórico de chat com o prompt
assistant, então o promptassistantdo template de chat (por exemplo,<|start_of_role|>assistant<|end_of_role|>) é uma escolha natural para a string de invocação. Consulte o template de chat do modelo para encontrar o prompt do modelo. - Opção 2: Se houver um prompt específico da tarefa para o adaptador que descreve a tarefa que o adaptador está aprendendo, e esse prompt for colocado como uma rodada de
userimediatamente antes da geração, então o prompt deuserdo modelo de chat (por exemplo,<|start_of_role|>user<|end_of_role|>) é uma escolha natural para a string de invocação.
Após decidir pela string de invocação, obtenha o tokenizer do modelo e obtenha alora_invocation_tokens como
alora_invocation_tokens = tokenizer.encode(invocation_string, add_special_tokens=False).Um exemplo de configuração de inferência está em alora finetuning.
Ao usar strings personalizadas para a string de invocação, certifique-se de que o início e o fim da string sejam tokens especiais para evitar problemas com a tokenização nas fronteiras.
Para entender o motivo, imagine que ‘a’, ‘b’, ‘c’ e ‘ab’ são tokens no seu tokenizer (números 1, 2, 3 e 4, respectivamente). Suponha que seu alora_invocation_tokens = [2, 3]. Agora imagine que sua string de entrada é “abc”. Como “ab” é um token, isso será tokenizado como [4,3]. Assim, o alora_invocation_tokens não será encontrado, apesar de a string “bc” estar presente nela. No entanto, se o início e o fim da string de invocação forem tokens especiais, esse caso de falha nunca ocorrerá, pois tokens especiais nunca são tokenizados no mesmo token junto com outros caracteres.
Usando (e reutilizando) cache para geração
O principal objetivo do aLoRA é tornar o cache de KV intercambiável entre o modelo base e os modelos adaptadores aLoRA antes da sequência de invocação, uma vez que os valores de KV do modelo base e do modelo adaptado não são compatíveis. Especificamente, as chaves e os valores armazenados durante uma geração de um modelo podem ser usados em gerações subsequentes para evitar operações de pré-preenchimento caras para tokens de contexto. Ao compartilhar o cache entre o modelo base e os adaptadores aLoRA, existem 2 padrões principais:
- O modelo base gerou algo e, em seguida, um adaptador aLoRA é chamado para fazer uma geração de acompanhamento. Por exemplo, o modelo base responde a uma pergunta e um aLoRA treinado para detectar alucinações verifica a resposta do modelo base.
- Um adaptador aLoRA gerou algo, e o modelo base ou um adaptador aLoRA diferente é chamado para fazer uma geração de acompanhamento em que há sobreposição parcial de contexto com o aLoRA original. Por exemplo, o usuário fornece uma consulta, e um aLoRA reescreve a consulta para que ela seja mais autossuficiente e melhore a recuperação em um sistema RAG. Em seguida, os documentos são recuperados e carregados no contexto, o aLoRA verifica se esses documentos são relevantes para a pergunta e, então, o modelo base gera uma resposta.
Para demonstrar os comportamentos acima ao usar cache, estamos usando DynamicCache do transformers. Tenha o cuidado de garantir que os valores de cache adaptados não sejam misturados com os valores de cache base. Em particular, uma etapa extra é necessária para compartilhar o cache quando há sobreposição parcial de contexto (padrão 2).
Padrão 1: modelo base seguido por aLoRA Aqui, a entrada e a geração inteiras do modelo base são fornecidas ao adaptador aLoRA, junto com a sequência de invocação:
from transformers import DynamicCache
...
cache = DynamicCache()
inputs_base = tokenizer(prompt_base, return_tensors="pt")
# Generate from base model and save cache
with model_alora.disable_adapter():
    output = model_alora.generate(inputs_base["input_ids"].to(device),attention_mask=inputs_base["attention_mask"].to(device),past_key_values = cache,return_dict_in_generate=True)
output_text_base = tokenizer.decode(output.sequences[0])
cache = output.past_key_values

# Generate with aLoRA adapter from cache
prompt_alora = output_text + INVOCATION_STRING
inputs_alora = tokenizer(prompt_alora, return_tensors="pt").to(device)
output = model_alora.generate(**inputs_alora, past_key_values=cache)
output_text_alora = tokenizer.decode(output[0])

# Note: cache is now tainted with adapter values and cannot be used in base model from here on!
Padrão 2: geração com aLoRA seguida pelo modelo base (ou outro aLoRA) com sobreposição parcial de contexto Aqui, fazemos o pré-preenchimento do contexto compartilhado usando o modelo base e, em seguida, geramos.
from transformers import DynamicCache
import copy
...
cache = DynamicCache()
inputs_shared = tokenizer(prompt_shared, return_tensors="pt").to(device)

# Prefill from base model and save cache
with model_alora.disable_adapter():
    with torch.no_grad():
        model_alora(**inputs_shared, past_key_values=cache)
cache_copy = copy.deepcopy(cache)

# Generate from aLoRA using prefilled cache
prompt_alora = prompt_shared + INVOCATION_STRING
inputs_alora = tokenizer(prompt_alora, return_tensors="pt").to(device)
output = model_alora.generate(**inputs_alora, past_key_values=cache)
output_text_alora = tokenizer.decode(output[0])

# Generate from base model using saved cache not tainted by aLoRA KV values
prompt_base = prompt_shared
inputs_base = tokenizer(prompt_base, return_tensors="pt").to(device)
with model_alora.disable_adapter():
    output = model_alora.generate(**inputs_base, past_key_values=cache_copy)
output_text_base = tokenizer.decode(output[0])
Inferência com diferentes adaptadores LoRA no mesmo lote
Normalmente, cada lote de inferência precisa usar o mesmo adaptador (ou adaptadores) no PEFT. Isso pode ser inconveniente às vezes, pois podemos ter lotes que contêm amostras destinadas a serem usadas com diferentes adaptadores LoRA. Por exemplo, poderíamos ter um modelo base que funciona bem em inglês e mais dois adaptadores LoRA, um para francês e outro para alemão. Normalmente, teríamos que dividir nossos lotes de modo que cada lote contenha apenas amostras de um dos idiomas; não podemos combinar diferentes idiomas no mesmo lote.
Felizmente, é possível misturar diferentes adaptadores LoRA no mesmo lote usando o argumento adapter_name. Abaixo, mostramos um exemplo de como isso funciona na prática. Primeiro, vamos carregar o modelo base, o inglês e os dois adaptadores, o francês e o alemão, da seguinte forma:
from transformers import AutoTokenizer, AutoModelForCausalLM
from peft import PeftModel

model_id = ...
tokenizer = AutoTokenizer.from_pretrained(model_id)

model = AutoModelForCausalLM.from_pretrained(model_id)
# load the LoRA adapter for French
peft_model = PeftModel.from_pretrained(model, <path>, adapter_name="adapter_fr")
# next, load the LoRA adapter for German
peft_model.load_adapter(<path>, adapter_name="adapter_de")
Agora, queremos gerar texto em uma amostra que contém os três idiomas: as três primeiras amostras estão em inglês, as três seguintes estão em francês e as três últimas estão em alemão. Podemos usar o argumento adapter_names para especificar qual adaptador usar para cada amostra. Como nosso modelo base é usado para o inglês, usamos a string especial "__base__" para essas amostras. Para as três amostras seguintes, indicamos o nome do adaptador do fine-tune LoRA em francês, neste caso "adapter_fr". Para as três últimas amostras, indicamos o nome do adaptador do fine-tune LoRA em alemão, neste caso "adapter_de". Dessa forma, podemos usar o modelo base e os dois adaptadores em um único lote.
inputs = tokenizer(
    [
        "Hello, my dog is cute",
        "Hello, my cat is awesome",
        "Hello, my fish is great",
        "Salut, mon chien est mignon",
        "Salut, mon chat est génial",
        "Salut, mon poisson est super",
        "Hallo, mein Hund ist süß",
        "Hallo, meine Katze ist toll",
        "Hallo, mein Fisch ist großartig",
    ],
    return_tensors="pt",
    padding=True,
)

adapter_names = [
    "__base__", "__base__", "__base__",
    "adapter_fr", "adapter_fr", "adapter_fr",
    "adapter_de", "adapter_de", "adapter_de",
]
output = peft_model.generate(**inputs, adapter_names=adapter_names, max_new_tokens=20)
Observe que a ordem não importa aqui, ou seja, as amostras no lote não precisam ser agrupadas por adaptador, como no exemplo acima. Basta garantir que o argumento adapter_names esteja alinhado corretamente com as amostras.
Além disso, a mesma abordagem também funciona com o recurso modules_to_save, que permite salvar e reutilizar camadas específicas de redes neurais, como cabeçalhos personalizados para tarefas de classificação, entre diferentes adaptadores LoRA.
Observações
O uso deste recurso apresenta algumas desvantagens, a saber:
- Funciona apenas para inferência, não para treinamento.
- Desativar adaptadores usando o contexto
with model.disable_adapter()tem precedência sobreadapter_names. - Você não pode passar
adapter_namesquando alguns pesos de adaptador foram mesclados com o peso base usando o métodomerge_adapter. Por favor, desfaça a mesclagem de todos os adaptadores primeiro, chamandomodel.unmerge_adapter(). Observe que mesclar apenas alguns dos adaptadores ativos tem uma observação semelhante fora deadapter_names. - Por razões óbvias, isso não pode ser usado após chamar
merge_and_unload(), pois, nesse caso, todos os adaptadores LoRA serão mesclados nos pesos base. - Este recurso não funciona atualmente com DoRA, portanto, defina
use_dora=Falseem seuLoraConfigse você quiser usá-lo. - O recurso
modules_to_saveé atualmente suportado apenas para camadas dos tiposLinear,Embedding,Conv2deConv1d. - Há um overhead esperado para inferência com
adapter_names, especialmente se a quantidade de adaptadores diferentes no lote for alta. Isso ocorre porque o tamanho do lote é efetivamente reduzido para o número de amostras por adaptador. Se o desempenho em tempo de execução for sua prioridade máxima, tente o seguinte:- Aumente o tamanho do lote.
- Tente evitar ter um grande número de adaptadores diferentes no mesmo lote; prefira lotes homogêneos. Isso pode ser alcançado ao fazer o buffer de amostras com o mesmo adaptador e executar a inferência apenas com um pequeno número de adaptadores diferentes.
- Dê uma olhada em implementações alternativas, como LoRAX, punica ou S-LoRA, que são especializadas para trabalhar com um grande número de adaptadores diferentes.
Compondo e Reutilizando Adaptadores LoRA
Arrow
Arrow é um algoritmo de roteamento modular projetado para combinar múltiplos adaptadores LoRA pré-treinados e específicos para tarefas, a fim de resolver uma tarefa dada, de forma semelhante ao Polytropon, mas sem a necessidade de ajuste fino. Em vez de mesclar todos os adaptadores de forma ingênua, o Arrow introduz um mecanismo de roteamento de mistura de especialistas (MoE) por token, livre de gradiente. No momento da inferência, ele primeiro calcula um protótipo para cada LoRA, extraindo o vetor singular direito principal de sua decomposição SVD. Cada representação de token é então comparada a esses protótipos por meio de similaridade de cosseno para obter os coeficientes de roteamento. Os tokens são atribuídos aos k adaptadores LoRA mais relevantes, com os coeficientes normalizados por meio de softmax, e suas saídas são combinadas linearmente. Isso permite a reutilização eficaz de módulos LoRA existentes para novas tarefas e leva a uma generalização zero-shot mais robusta.
In PEFT, Arrow is enabled through [`ArrowConfig]andcreate_arrow_model. You can also configure parameters such astop_k(the number of LoRA adapters combined per token),router_temperature(the softmax temperature applied to the routing coefficients), andrng_seed` (for reproducibility).
from peft import create_arrow_model, ArrowConfig
from transformers import AutoModelForCausalLM

# Loading the model
base_model = AutoModelForCausalLM.from_pretrained("microsoft/Phi-3-mini-4k-instruct")

# Creating the Arrow config
arrow_config = ArrowConfig(
    top_k=3,
    router_temperature=1.0,
    rng_seed=42,
)

# The LoRA adapters below were trained on a clustered FLAN dataset.
# Task clustering was performed using the Model-Based Clustering (MBC) method,
# as described in the Arrow paper.
# While one could train a separate LoRA for each task and let Arrow route tokens among them,
# training LoRAs on clusters of tasks instead provides an indirect optimization for
# transfer across the multi-task dataset.
task_specific_adapter_paths = [
        f"TahaBa/phi3-mini-clustered-flan/ts_expert_{i}" for i in range(10)
    ]

# Creating the Arrow model
model = create_arrow_model(
        base_model=base_model,
        task_specific_adapter_paths=task_specific_adapter_paths,
        arrow_config=arrow_config,
    )

# Now the forward path could be called on this model, like a normal PeftModel.
Além disso, você pode adicionar ou remover adaptadores após chamar create_arrow_model—por exemplo, para fazer o ajuste fino de um novo adaptador ou descartar um desnecessário. Uma vez que os adaptadores estejam configurados, você pode ativar o "arrow_router" para inferência e usar o Arrow. Observe que, se você adicionar um novo adaptador LoRA após create_arrow_model e quiser fazer o ajuste fino dele, deve definir explicitamente o novo adaptador como ativo, pois "arrow_router" é ativado por padrão em create_arrow_model.
from trl import SFTTrainer, SFTConfig

# Adding a new adapter and activating it
model.add_adapter(adapter_name='new_adapter')
model.set_adapter('new_adapter')

# Now the model could be trained along the `new_adapter`.
trainer = SFTTrainer(
        model=model,
        args=SFTConfig(...),
        ...
    )

# Once the training is done, you can activate `arrow_router` and use it in inference
model.set_adapter('arrow_router')    # Model is ready to be used at inference time now
GenKnowSub
GenKnowSub aprimora o Arrow purificando adaptadores LoRA específicos de tarefa antes do roteamento. A ideia central é subtrair o conhecimento geral codificado no espaço LoRA—com base no princípio do esquecimento por negação—para que os adaptadores de tarefa fiquem mais isolados e focados nos sinais relevantes para a tarefa. Concretamente, o GenKnowSub estima um subespaço “geral” de baixa dimensão a partir de um conjunto de adaptadores LoRA gerais (não específicos de tarefa) e remove esse componente da atualização LoRA de cada adaptador de tarefa antes do roteamento token a token do Arrow. Isso geralmente melhora a composicionalidade e reduz a interferência ao combinar muitos adaptadores de tarefa.
No PEFT, ative o GenKnowSub definindo use_gks=True em ArrowConfig e fornecendo general_adapter_paths em create_arrow_model:
from peft import create_arrow_model, ArrowConfig
from transformers import AutoModelForCausalLM

# Loading the model
base_model = AutoModelForCausalLM.from_pretrained("microsoft/Phi-3-mini-4k-instruct")

# Creating the Arrow config
arrow_config = ArrowConfig(
    top_k=3,
    router_temperature=1.0,
    use_gks=True,
    rng_seed=42,
)

# Path to task-specific, trained on flan clustered dataset (as we explained before.)
task_specific_adapter_paths = [
        f"TahaBa/phi3-mini-clustered-flan/ts_expert_{i}" for i in range(10)
    ]
# These general adapters are trained on English, German, and French Wikipedia dataset,
# with causal language modelling objective, each pair like: (507 token tsentence, 5 token completion), and the loss computed on the completion
general_adapter_paths = [
        "TahaBa/phi3-mini-general-adapters/cluster0_batch16_prop1.0_langen/checkpoint-17",
        "TahaBa/phi3-mini-general-adapters/cluster0_batch16_prop1.0_langfr/checkpoint-35",
        "TahaBa/phi3-mini-general-adapters/cluster0_batch16_prop1.0_langger/checkpoint-17"
    ]

# Creating the Arrow model
model = create_arrow_model(
        base_model=base_model,
        task_specific_adapter_paths=task_specific_adapter_paths,
        general_adapter_paths=general_adapter_paths,
        arrow_config=arrow_config,
    )

# Now the forward path could be called on this model, like a normal PeftModel.
Para codificar conhecimento geral, o GenKnowSub subtrai a média dos adaptadores gerais fornecidos de cada adaptador específico para a tarefa uma única vez, antes do início do roteamento. Além disso, a capacidade de adicionar ou remover adaptadores após a chamada de create_arrow_model (conforme descrito na seção Arrow) ainda é suportada neste caso.
Coisas a ter em mente ao usar Arrow + GenKnowSub:
Todos os adaptadores LoRA (específicos de tarefa e gerais) devem compartilhar o mesmo
ranketarget_modules.Qualquer inconsistência nessas configurações causará um erro em
create_arrow_model.O uso de diferentes fatores de escala (
lora_alpha) entre adaptadores de tarefa é suportado — o Arrow os trata automaticamente.A mesclagem do
"arrow_router"não é suportada, devido ao seu comportamento de roteamento dinâmico.Em
create_arrow_model, os adaptadores de tarefa são carregados comotask_ie os adaptadores gerais comogks_j(ondeiejsão índices). A função garante a consistência detarget_modules,ranke se os adaptadores são aplicados a camadasLinearouLinear4bit. Em seguida, adiciona o módulo"arrow_router"e o ativa. Qualquer personalização desse processo exige a sobrescrita decreate_arrow_model.Esta implementação é compatível com quantização de 4 bits (via bitsandbytes):
from transformers import AutoModelForCausalLM, BitsAndBytesConfig
import torch

# Quantisation config
bnb_config = BitsAndBytesConfig(
        load_in_4bit=True,
        bnb_4bit_quant_type="nf4",
        bnb_4bit_compute_dtype=torch.bfloat16,
        bnb_4bit_use_double_quant=False,
    )

# Loading the model
base_model = AutoModelForCausalLM.from_pretrained(
    "microsoft/Phi-3-mini-4k-instruct",
    dtype=torch.bfloat16,
    device_map="auto",
    quantization_config=bnb_config,
)

# Now call create_arrow_model() as we explained before.
API
LoraConfig
classe peft.LoraConfig
< source >( task_type: Optional[Union[str, TaskType]] = Nonepeft_type: Optional[Union[str, PeftType]] = Noneauto_mapping: Optional[dict] = Nonepeft_version: Optional[str] = Nonebase_model_name_or_path: Optional[str] = Nonerevision: Optional[str] = Noneinference_mode: bool = Falser: int = 8target_modules: Optional[Union[list[str], str]] = Noneexclude_modules: Optional[Union[list[str], str]] = Nonelora_alpha: int = 8lora_dropout: float = 0.0fan_in_fan_out: bool = Falsebias: Literal['none', 'all', 'lora_only'] = 'none'use_rslora: bool = Falsemodules_to_save: Optional[list[str]] = Noneinit_lora_weights: bool | Literal['gaussian', 'eva', 'olora', 'pissa', 'pissa_niter_[number of iters]', 'corda', 'astra', 'loftq', 'orthogonal', 'mica', 'nora'] = Truelayers_to_transform: Optional[Union[list[int], int]] = Nonelayers_pattern: Optional[Union[list[str], str]] = Nonerank_pattern: Optional[dict] = <factory>alpha_pattern: Optional[dict] = <factory>megatron_config: Optional[dict] = Nonemegatron_core: Optional[str] = 'megatron.core'trainable_token_indices: Optional[Union[list[int], dict[str, list[int]]]] = Noneloftq_config: Union[LoftQConfig, dict] = <factory>eva_config: Optional[EvaConfig] = Nonecorda_config: Optional[CordaConfig] = Noneastra_config: Optional[AstraConfig] = Nonelora_ga_config: Optional[LoraGAConfig] = Noneuse_dora: bool = Falsevelora_config: Optional[Union[VeloraConfig, dict]] = Nonealora_invocation_tokens: Optional[list[int]] = Noneuse_qalora: bool = Falseqalora_group_size: int = 16monteclora_config: Optional[MontecloraConfig] = Nonelayer_replication: Optional[list[tuple[int, int]]] = Noneruntime_config: LoraRuntimeConfig = <factory>lora_bias: bool = Falsetarget_parameters: Optional[list[str]] = Noneuse_bdlora: Optional[BdLoraConfig] = Nonearrow_config: Optional[ArrowConfig] = Nonekasa_config: Optional[KasaConfig] = Noneensure_weight_tying: bool = False )
Parâmetros
- r (
int) — Dimensão de atenção Lora (o “rank”). - target_modules (
Optional[Union[List[str], str]]) — Os nomes dos módulos aos quais o adaptador será aplicado. Se especificado, apenas os módulos com os nomes especificados serão substituídos. Ao passar uma string, uma correspondência de expressão regular será realizada. Ao passar uma lista de strings, será realizada uma correspondência exata ou será verificado se o nome do módulo termina com qualquer uma das strings passadas. Se especificado como ‘all-linear’, todos os módulos lineares/Conv1D serão escolhidos (se o modelo for um PreTrainedModel, a camada de saída será excluída). Se não for especificado, os módulos serão escolhidos de acordo com a arquitetura do modelo. Se a arquitetura não for conhecida, um erro será lançado — nesse caso, você deve especificar os módulos de destino manualmente. Para evitar direcionar a qualquer módulo (porque você deseja aplicartarget_parameters), definatarget_modules=[]. - exclude_modules (
Optional[Union[List[str], str]]) — Os nomes dos módulos para os quais o adaptador não deve ser aplicado. Ao passar uma string, será realizada uma correspondência por expressão regular. Ao passar uma lista de strings, será realizada uma correspondência exata ou será verificado se o nome do módulo termina com qualquer uma das strings passadas. - lora_alpha (
int) — O parâmetro alpha para o escalonamento do Lora. - lora_dropout (
float) — A probabilidade de dropout para as camadas Lora. - fan_in_fan_out (
bool) — Defina como True se a camada a ser substituída armazenar os pesos como (fan_in, fan_out). Por exemplo, o gpt-2 usaConv1D, que armazena os pesos como (fan_in, fan_out), e portanto este parâmetro deve ser definido comoTrue. - bias (
str) — Tipo de viés para LoRA. Pode ser ‘none’, ‘all’ ou ‘lora_only’. Se for ‘all’ ou ‘lora_only’, os vieses correspondentes serão atualizados durante o treinamento. Tenha em mente que isso significa que, mesmo ao desativar os adaptadores, o modelo não produzirá a mesma saída que o modelo base teria sem adaptação. - use_rslora (
bool) — Quando definido como True, usa Rank-Stabilized LoRA, que define o fator de escala do adaptador comolora_alpha/math.sqrt(r), pois foi provado que funciona melhor. Caso contrário, será usado o valor padrão original delora_alpha/r. - modules_to_save (
List[str]) — Lista de módulos, além das camadas de adaptador, que devem ser configurados como treináveis e salvos no checkpoint final. - init_lora_weights (
bool|Literal["gaussian", "eva", "olora", "pissa", "pissa_niter_[number of iters]", "corda", "astra", "loftq", "orthogonal", "mica", "nora"]) — Como inicializar os pesos das camadas do adaptador. Passar True (padrão) resulta na inicialização padrão da implementação de referência da Microsoft, com o peso do LoRA B definido como 0. Isso significa que, sem treinamento adicional, o adaptador LoRA será um no-op. Definir a inicialização como False leva à inicialização aleatória do LoRA A e B, o que significa que o LoRA não é um no-op antes do treinamento; essa configuração é destinada a fins de depuração. Passar 'gaussian' resulta em inicialização gaussiana escalada pelo rank do LoRA para camadas lineares e de incorporação. Passar'loftq'para usar a inicialização LoftQ. Passar'eva'resulta em uma inicialização baseada em dados de Adaptação de Variância Explicada. O EVA inicializa o LoRA com base na SVD das ativações de entrada da camada e alcança desempenho SOTA devido à sua capacidade de se adaptar aos dados de ajuste fino. Passar'olora'para usar a inicialização OLoRA. Passar'pissa'resulta na inicialização de https://huggingface.co/papers/2404.02948’ Principal Singular values and Singular vectors Adaptation (PiSSA), que converge mais rapidamente que o LoRA e, em última análise, alcança desempenho superior. Além disso, o PiSSA reduz o erro de quantização em comparação com o QLoRA, levando a melhorias adicionais. Passar 'pissa_niter_[number of iters]' inicia a inicialização PiSSA baseada em Fast-SVD, onde [number of iters] indica o número de iterações de subespaço para executar o FSVD e deve ser um inteiro não negativo. Quando [number of iters] é definido como 16, a inicialização de um modelo de 7B pode ser concluída em segundos, e o efeito do treinamento é aproximadamente equivalente ao uso de SVD. Passar 'corda' resulta na inicialização de Context-Oriented Decomposition Adaptation, que converge ainda mais rapidamente que o PiSSA no Modo de Pré-visualização de Instruções e preserva melhor o conhecimento do mundo no Modo de Preservação de Conhecimento. Passar 'astra' resulta na inicialização de Activation-Space Tail-Eigenvector Low-Rank Adaptation, que projeta o peso base no autoespaço das ativações de saída estimado a partir de um pequeno conjunto de dados de calibração. Passar "orthogonal" resulta em LoRA A e B sendo inicializados ortogonalmente; nisso, se assemelha a "olora", mas os pesos base são deixados intactos (exige que r seja par, atualmente suportado apenas para camadas lineares). Passar "mica" resulta na inicialização de Minor Component Adaptation (MiCA), que inicializa B a partir dos r autovetores à esquerda do peso base associados aos menores valores singulares, define A como zero e congela B durante o treinamento; apenas A é atualizado. Atualmente suportado para camadas lineares e de incorporação. Passar "nora" resulta na inicialização de Normalized Low-Rank Adaptation (NoRA), que normaliza cada coluna do peso do LoRA A inicializado aleatoriamente para norma L2 unitária e define o peso do LoRA B como zero. A normalização é aplicada apenas na inicialização; os pesos base não são alterados e tanto A quanto B permanecem treináveis. A configuração recomendada é lora_alpha igual a r com use_rslora=False, o que mantém uma proporção de 1:1 e um fator de escala de 1. Atualmente suportado para camadas lineares e para nn.Parameters visados com target_parameters.Principal Singular values and Singular vectors Adaptation (PiSSA), que converge mais rapidamente que LoRA e, em última análise, atinge desempenho superior. Além disso, o PiSSA reduz o erro de quantização em comparação com o QLoRA, levando a melhorias adicionais. Passar
'pissa_niter_[number of iters]'inicia a inicialização do PiSSA baseada em Fast-SVD, onde[number of iters]indica o número de iterações de subespaço para executar o FSVD e deve ser um inteiro não negativo. Quando[number of iters]é definido como 16, é possível completar a inicialização de um modelo de 7B em segundos, e o efeito do treinamento é aproximadamente equivalente ao uso de SVD. Passar'corda'resulta na inicialização de Context-Oriented Decomposition Adaptation, que converge ainda mais rapidamente que o PiSSA no Instruction-Previewed Mode e preserva melhor o conhecimento do mundo no Knowledge-Preserved Mode. Passar'astra'resulta na inicialização de Activation-Space Tail-Eigenvector Low-Rank Adaptation, que projeta o peso base no autoespaço das ativações de saída estimadas a partir de um pequeno conjunto de dados de calibração. Passar"orthogonal"resulta na inicialização ortogonal de LoRA A e B; neste caso, assemelha-se a"olora", mas os pesos base permanecem intactos (exige querseja par, atualmente suportado apenas para camadas lineares). Passar"mica"resulta na inicialização de Minor Component Adaptation (MiCA), que inicializa B a partir dos r vetores singulares à esquerda do peso base associados aos menores valores singulares, define A como zero e congela B durante o treinamento; apenas A é atualizado. Atualmente suportado para camadas lineares e de incorporação (embedding). Passar"nora"resulta na inicialização de Normalized Low-Rank Adaptation (NoRA), que normaliza cada coluna do peso LoRA A inicializado aleatoriamente para norma L2 unitária e define o peso LoRA B como zero. A normalização é aplicada apenas na inicialização; os pesos base permanecem inalterados e tanto A quanto B permanecem treináveis. A configuração recomendada élora_alphaigual arcomuse_rslora=False, o que mantém uma proporção de 1:1 e um fator de escala de 1. Atualmente suportado para camadas lineares e parann.Parameters alvo detarget_parameters. - layers_to_transform (
Union[List[int], int]) — Os índices das camadas a serem transformadas. Se uma lista de inteiros for passada, o adaptador será aplicado aos índices das camadas especificados nessa lista. Se um único inteiro for passado, as transformações serão aplicadas à camada nesse índice. - layers_pattern (
Optional[Union[List[str], str]]) — O nome do padrão de camadas, usado apenas selayers_to_transformfor diferente deNone. Isso deve apontar para onn.ModuleListdo modelo, que frequentemente é chamado de'layers'ou'h'. - rank_pattern (
dict) — O mapeamento de nomes de camadas ou expressões regulares para ranks que são diferentes do rank padrão especificado porr. Por exemplo,{'^model.decoder.layers.0.encoder_attn.k_proj': 16}. - alpha_pattern (
dict) — O mapeamento de nomes de camadas ou expressões regulares para alfas que são diferentes do alfa padrão especificado porlora_alpha. Por exemplo,{'^model.decoder.layers.0.encoder_attn.k_proj': 16}. - megatron_config (
Optional[dict]) — Os argumentos do TransformerConfig para o Megatron. É usado para criar a camada linear paralela do LoRA. Você pode obtê-lo da seguinte forma,core_transformer_config_from_args(get_args()), sendo essas duas funções do Megatron. Os argumentos serão usados para inicializar o TransformerConfig do Megatron. Você precisa especificar este parâmetro quando quiser aplicar LoRA às camadas ColumnParallelLinear e RowParallelLinear do megatron. - megatron_core (
Optional[str]) — O módulo principal do Megatron a ser usado, padrão é"megatron.core". - trainable_token_indices (
Optional[Union[List[int], dict[str, List[int]]]]) — Permite especificar quais índices de tokens devem ser ajustados seletivamente, sem a necessidade de re-treinar toda a matriz de incorporação, usando o métodopeft.TrainableTokensModel. Você pode especificar os índices de tokens de duas maneiras. Ou você especifica uma lista de índices, que então terá como alvo a camada de incorporação de entrada do modelo (ou, se não for encontrada,embed_tokens). Alternativamente, você pode especificar um dicionário onde a chave é o nome do módulo de incorporação e os valores são a lista de índices de tokens, por exemplo,{'embed_tokens': [0, 1, ...]}. Observe que o treinamento com FSDP requeruse_orig_params=Truepara evitar problemas comrequires_gradnão uniforme. - loftq_config (
Optional[LoftQConfig]) — A configuração do LoftQ. Se este valor não for None, o LoftQ será usado para quantizar os pesos do backbone e inicializar as camadas Lora. Também passeinit_lora_weights='loftq'. Observe que você não deve passar um modelo quantizado neste caso, pois o LoftQ quantizará o modelo por conta própria. O LoftQ é aplicado apenas a camadas lineares, incluindo aquelas alvo viatarget_parameters. Camadas de embedding e convolucionais não são suportadas e usam a inicialização padrão do LoRA no lugar. Camadasnn.MultiheadAttentionnão são suportadas e geram um erro. - eva_config (
Optional[EvaConfig]) — A configuração do EVA. No mínimo, o argumento de dataset precisa ser definido (use o mesmo dataset utilizado para o finetuning). - corda_config (
Optional[CordaConfig]) — A configuração do CorDA. Se este valor não for None, o CorDA será usado para construir as camadas do adaptador. Também passeinit_lora_weights='corda'. - astra_config (
Optional[AstraConfig]) — A configuração do Astra. Se este valor não for None, o Astra será usado para construir as camadas do adaptador. Nesse caso, também passeinit_lora_weights='astra'e chamepreprocess_astraantes deget_peft_model. - lora_ga_config (
Optional[LoraGAConfig]) — A configuração do LoRA-GA. Se isso for passado, o LoRA-GA será usado para inicializar as camadas do adaptador. Também definainit_lora_weights='lora_ga'nesse caso. - use_dora (
bool) — Ativa o ‘Weight-Decomposed Low-Rank Adaptation’ (DoRA). Essa técnica decompõe as atualizações dos pesos em duas partes, magnitude e direção. A direção é tratada pelo LoRA normal, enquanto a magnitude é tratada por um parâmetro aprendível separado. Isso pode melhorar o desempenho do LoRA, especialmente em ranks baixos. No momento, o DoRA suporta apenas camadas lineares e Conv2D. O DoRA introduz um overhead maior do que o LoRA puro, portanto, é recomendado mesclar os pesos para inferência. Para mais informações, veja https://huggingface.co/papers/2402.09353. - velora_config (
Optional[VeloraConfig]) — Ative o VeLoRA fornecendo um VeloraConfig. O VeLoRA substitui o backward pass personalizado para a projeção A do LoRA, armazenando ativações comprimidas em vez das ativações de entrada completas. - kasa_config (
Optional[KasaConfig]) — Ative o KaSA (Knowledge-aware Singular-value Adaptation) fornecendo um KasaConfig. O KaSA truncar osrcomponentes singulares menores dos pesos base congelados por meio de uma SVD única e insere um diagonal aprendível de valores singulares entre os fatores A e B do LoRA. Atualmente, apenas camadas lineares são suportadas. - alora_invocation_tokens (
List[int]) — Se não for None, ativa o ‘Activated LoRA’ (aLoRA), sendo alora_invocation_tokens a string de invocação tokenizada para o adaptador (deve estar presente em todas as strings de entrada do modelo). Essa técnica ativa seletivamente os pesos do adaptador apenas nos tokens durante e após os alora_invocation_tokens. Quando usado em um CausalLM, isso significa que o cache KV anterior à invocação é intercambiável com o do modelo base (e com outros adaptadores aLoRA que operam dessa forma). Como resultado, em pipelines de inferência que envolvem alternância entre inferência do modelo base e inferência do adaptador (por exemplo, pipelines agênticos, veja o paper para exemplos), economias significativas são realizadas (em relação ao LoRA) ao salvar operações de prefill. Acelerações gerais de inferência do adaptador de uma ordem de grandeza ou mais podem ocorrer no vLLM, dependendo do comprimento do contexto compartilhado. Observe que a mesclagem não é possível devido à aplicação seletiva dos pesos. - use_qalora (
bool) — Atualmente, é implementado apenas no GPTQ. Ativa Quantization-Aware Low-Rank Adaptation (QALoRA). Essa técnica combina treinamento consciente de quantização com LoRA para melhorar o desempenho de modelos quantizados. Isso pode melhorar o desempenho do LoRA, especialmente em ranks baixos. No momento, o QALoRA suporta apenas camadas lineares. - qalora_group_size (
int) — Parâmetro de tamanho de grupo para o pooling do QALoRA, que controla o fator de redução de dimensão. As dimensões de entrada são agrupadas em grupos deste tamanho, reduzindo o custo computacional. Valores maiores proporcionam mais compressão, mas podem reduzir a qualidade do modelo. Este parâmetro determina quantos recursos originais são agregados por média para criar um recurso agrupado. Usado apenas quandouse_qalora=True. - monteclora_config (
Optional[MontecloraConfig]) — A configuração do Monteclora (Monte Carlo Low-Rank Adaptation). Se fornecida, o Monteclora será usado para adicionar amostragem variacional de Monte Carlo sobre os adaptadores LoRA. ConsulteMontecloraConfigpara detalhes sobre os hiperparâmetros individuais. - layer_replication (
List[Tuple[int, int]]) — Constrói uma nova pilha de camadas empilhando as camadas do modelo original de acordo com os intervalos especificados. Isso permite expandir (ou reduzir) o modelo sem duplicar os pesos do modelo base. Todas as novas camadas terão adapters LoRA separados anexados a elas. - runtime_config (
LoraRuntimeConfig) — Configurações de tempo de execução (que não são salvas nem restauradas). - lora_bias (
bool) — Padrão:False. Indica se o termo de viés deve ser habilitado para o parâmetro B do LoRA. Normalmente, isso deve ser desabilitado. O principal caso de uso é quando os pesos do LoRA foram extraídos de parâmetros totalmente ajustados, para que o viés desses parâmetros possa ser considerado. - target_parameters (
List[str], opcional) — Lista de nomes de parâmetros a serem substituídos por LoRA. Este argumento se comporta de forma semelhante atarget_modules, exceto pelo fato de que o nome do parâmetro deve ser passado. Em geral, você deve usartarget_modulespara direcionar o módulo (por exemplo,nn.Linear). No entanto, em algumas circunstâncias, isso não é possível. Por exemplo, em muitas camadas de mixture of expert (MoE) em HF Transformers, em vez de usarnn.Linear, umnn.Parameteré utilizado. O PEFT normalmente sobrescreve o métodoforwardpara LoRA, mas parann.Parameter, não há nenhum. Portanto, para aplicar LoRA a esse parâmetro, ele precisa ser direcionado comtarget_parameters. Como exemplo, para Llama4, você pode passar:target_parameters=['feed_forward.experts.gate_up_proj', 'feed_forward.experts.down_proj]. Passar uma string para correspondência por regex ainda não está implementado. Observe que, quando o modelo é compilado e usatarget_parameters, a recompilação e/ou quebras de grafo são esperadas. Recomenda-se não usar ambos ao mesmo tempo. - use_bdlora (
Optional[BdLoraConfig]) — Ative o BD-LoRA (Block-Diagonal LoRA) fornecendo um BdLoraConfig. Essa técnica usa matrizes bloco-diagonais para os fatores LoRA-A ou LoRA-B para permitir um atendimento multi-LoRA mais rápido, eliminando os sobrecustos de comunicação em configurações distribuídas. - arrow_config (
Optional[ArrowConfig]) — A configuração necessária para aplicar o roteamento arrow no modelo. - ensure_weight_tying (
bool, opcional) — Se as weights devem ser atreladas ou não após a inicialização do peft. Isso garante que os adaptadores adicionados às camadas atreladas também sejam atrelados. Isso se aplica apenas às camadas passadas viamodules_to_saveetarget_modules.
Esta é a classe de configuração para armazenar a configuração de um LoraModel.
Retorna a configuração do seu modelo de adaptador como um dicionário. Remove as configurações de tempo de execução.
LoraModel
classe peft.LoraModel
< source >( modelpeft_config: Union[PeftConfig, dict[str, PeftConfig]]adapter_name: strlow_cpu_mem_usage: bool = Falsestate_dict: Optional[dict[str, torch.Tensor]] = None ) → torch.nn.Module
Parâmetros
- model (
torch.nn.Module) — O modelo a ser adaptado. - config (LoraConfig) — A configuração do modelo Lora.
- adapter_name (
str) — O nome do adaptador, padrão é"default". - low_cpu_mem_usage (
bool,optional, defaults toFalse) — Cria pesos de adaptador vazios no dispositivo meta. Útil para acelerar o processo de carregamento.
Retorna
torch.nn.Module
O modelo Lora.
Cria um modelo Low Rank Adapter (LoRA) a partir de um modelo de transformers pré-treinado.
O método é descrito em detalhes em https://huggingface.co/papers/2106.09685.
Exemplo:
>>> from transformers import AutoModelForSeq2SeqLM
>>> from peft import LoraConfig, get_peft_model

>>> config = LoraConfig(
...     task_type="SEQ_2_SEQ_LM",
...     r=8,
...     lora_alpha=32,
...     target_modules=["q", "v"],
...     lora_dropout=0.01,
... )

>>> model = AutoModelForSeq2SeqLM.from_pretrained("t5-base")
>>> lora_model = get_peft_model(model, config)>>> import torch
>>> import transformers
>>> from peft import LoraConfig, get_peft_model, prepare_model_for_kbit_training
>>> rank = ...
>>> target_modules = ["q_proj", "k_proj", "v_proj", "out_proj", "fc_in", "fc_out", "wte"]
>>> config = LoraConfig(
... r=4, lora_alpha=16, target_modules=target_modules, lora_dropout=0.1, bias="none", task_type="CAUSAL_LM"
... )
>>> quantization_config = transformers.BitsAndBytesConfig(load_in_8bit=True)
>>> tokenizer = transformers.AutoTokenizer.from_pretrained(
... "kakaobrain/kogpt",
... revision="KoGPT6B-ryan1.5b-float16", # or float32 version: revision=KoGPT6B-ryan1.5b
... bos_token="[BOS]",
... eos_token="[EOS]",
... unk_token="[UNK]",
... pad_token="[PAD]",
... mask_token="[MASK]",
... )
>>> model = transformers.GPTJForCausalLM.from_pretrained(
... "kakaobrain/kogpt",
... revision="KoGPT6B-ryan1.5b-float16", # or float32 version: revision=KoGPT6B-ryan1.5b
... pad_token_id=tokenizer.eos_token_id,
... use_cache=False,
... device_map={"": rank},
... torch_dtype=torch.float16,
... quantization_config=quantization_config,
... )
>>> model = prepare_model_for_kbit_training(model)
>>> lora_model = get_peft_model(model, config)Atributos:
- model (PreTrainedModel) — O modelo a ser adaptado.
- peft_config (LoraConfig): A configuração do modelo Lora.
add_weighted_adapter
< source >( adapters: list[str]weights: list[float]adapter_name: strcombination_type: Literal['svd', 'linear', 'cat', 'ties', 'ties_svd', 'dare_ties', 'dare_linear', 'dare_ties_svd', 'dare_linear_svd', 'magnitude_prune', 'magnitude_prune_svd'] = 'svd'svd_rank: int | None = Nonesvd_clamp: int | None = Nonesvd_full_matrices: bool = Truesvd_driver: str | None = Nonedensity: float | None = Nonemajority_sign_method: Literal['total', 'frequency'] = 'total' )
Parâmetros
- adapters (
list) — Lista de nomes de adaptadores a serem mesclados. - weights (
list) — Lista de pesos para cada adaptador. Os pesos podem ser positivos ou negativos, permitindo tanto a adição quanto a subtração dos efeitos dos adaptadores. - adapter_name (
str) — Nome do novo adaptador. - combination_type (
str) — O tipo de mesclagem pode ser um de [svd,linear,cat,ties,ties_svd,dare_ties,dare_linear,dare_ties_svd,dare_linear_svd,magnitude_prune,magnitude_prune_svd]. Ao usar ocatcomo combination_type, o rank do adaptador resultante é igual à soma dos ranks de todos os adaptadores (o adaptador misto pode ficar grande demais e resultar em erros de OOM). Observe quecatesvdsão métodos precisos e fornecerão boa precisão, enquantolinearé eficiente, mas uma aproximação muito grosseira e deve ser evitado, se possível. - svd_rank (
int, opcional) — Rank do adaptador de saída para svd. Se None for fornecido, será usado o rank máximo dos adaptadores de mesclagem. - svd_clamp (
float, opcional) — Um limiar de quantil para limitar a saída da decomposição SVD. Se None for fornecido, não executar o limitação. Padrão: None. - svd_full_matrices (
bool, opcional) — Controla se o SVD completo ou reduzido deve ser calculado e, consequentemente, a forma dos tensores U e Vh retornados. O valor padrão é True. - svd_driver (
str, opcional) — Nome do método do cuSOLVER a ser utilizado. Este argumento de palavra-chave só funciona ao mesclar em CUDA. Pode ser um de [None,gesvd,gesvdj,gesvda]. Para mais informações, consulte a documentação detorch.linalg.svd. Padrão: None. - density (
float, opcional) — Valor entre 0 e 1. 0 significa que todos os valores são podados e 1 significa que nenhum valor é podado. Deve ser usado com [ties,ties_svd,dare_ties,dare_linear,dare_ties_svd,dare_linear_svd,magnintude_prune,magnitude_prune_svd] - majority_sign_method (
str) — O método, deve ser um de [“total”, “frequency”], a ser usado para obter a magnitude dos valores de sinal. Deve ser usado com [ties,ties_svd,dare_ties,dare_ties_svd]
Este método adiciona um novo adaptador mesclando os adaptadores fornecidos com os pesos fornecidos.
Ao usar o combination_type cat, é importante estar ciente de que o rank do adaptador resultante será igual à soma dos ranks de todos os adaptadores. Portanto, é possível que o adaptador misturado fique grande demais e resulte em erros de OOM.
subtract_mutated_init
< source >( output_state_dict: dict[str, torch.Tensor]adapter_name: strkwargs = None )
Esta função pode calcular as atualizações de PiSSA/CorDA/OLoRA comparando os parâmetros do adaptador PiSSA/CorDA/OLoRA em output_state_dict com os valores iniciais de PiSSA/CorDA/OLoRA em adapter_name, convertendo assim PiSSA/CorDA/OLoRA em LoRA.
Métodos como PiSSA removem uma parte dos pesos base do modelo para o treinamento e, portanto, não são facilmente substituídos. Mas, se você conhece tanto os pesos do pré-treinamento inicial quanto os pesos do pós-treinamento, pode calcular o \Delta W e usá-lo como um adaptador LoRA.
Etapas de computação:
- (inicialização do PiSSA)
- (PiSSA após o treinamento)
- (Derivando dW para LoRA)
Utilitário
ArrowConfig
classe peft.ArrowConfig
< source >( top_k: int = 3router_temperature: float = 1.0use_gks: bool = Falserng_seed: Optional[int] = None )
Esta é a classe de subconfiguração para armazenar a configuração do algoritmo Arrow e GenKnowSub. O Arrow é um algoritmo de roteamento para combinar os módulos LoRA treinados a fim de resolver novas tarefas, proposto em ’https://huggingface.co/papers/2405.11157’. O GenKnowSub é um refinamento nos módulos treinados antes de serem combinados via Arrow, introduzido em ’https://aclanthology.org/2025.acl-short.54/’
LoftQ
replace_lora_weights_loftq
peft.replace_lora_weights_loftq
< source >( peft_modelmodel_path: Optional[str] = Noneadapter_name: str = 'default'callback: Optional[Callable[[torch.nn.Module, str], bool]] = None )
Parâmetros
- peft_model (
PeftModel) — O modelo cujos pesos devem ser substituídos. Deve ser um modelo PEFT quantizado com camadas LoRA. - model_path (
Optional[str]) — O caminho para o arquivo safetensors do modelo. Se o modelo for um modelo do Hugging Face, isso será inferido a partir da configuração do modelo. Caso contrário, ele deve ser fornecido. - adapter_name (
str) — O nome do adaptador para substituir os pesos. O nome padrão do adaptador é “default”. - callback (
Optional[Callable[[PeftModel, str], bool]]) — Uma função de callback que será chamada após cada módulo ser substituído. A função de callback deve receber o modelo e o nome do módulo atual como entrada e retornar um booleano indicando se a substituição deve ser mantida. Se o callback retornar False, a substituição será revertida. Isso pode ser muito útil para confirmar que a inicialização do LoftQ realmente diminui o erro de quantização do modelo. Como exemplo, esse callback poderia gerar logits para uma entrada dada e compará-los com os logits do modelo original, não quantizado, com a mesma entrada, e retornar apenasTruese houver uma melhoria. Como se trata de uma otimização gulosa, é possível que chamar essa função várias vezes resulte em melhorias incrementais.
Substitua os pesos LoRA de um modelo quantizado com bitsandbytes, usando a técnica LoftQ.
A substituição é feita em tempo de execução, carregando os pesos não quantizados de um arquivo de modelo safetensors armazenado localmente e inicializando os pesos do LoRA de modo que o erro de quantização entre os pesos originais e os pesos quantizados seja minimizado.
Como o carregamento preguiçoso não é possível com pickle, os arquivos de checkpoint do PyTorch normais não podem ser suportados.
Dependendo do tamanho do modelo, a chamada a esta função pode levar algum tempo para ser concluída.
LoftQConfig
classe peft.LoftQConfig
< source >( loftq_bits: int = 4loftq_iter: int = 1 )
Esta é a classe de subconfiguração para armazenar a configuração de um LoraModel.
Eva
EvaConfig
classe peft.EvaConfig
< source >( rho: float = 2.0tau: float = 0.99use_label_mask: bool = Truelabel_mask_value: int = -100whiten: bool = Falseadjust_scaling_factors: bool = True )
Parâmetros
- rho (
float) — Valor de Rho para a redistribuição do EVA (>= 1.0). O rank máximo para uma camada é lora_r * rho. O padrão é 2.0, o que significa que o rank máximo permitido para uma camada é 2r. Aumentar o rho permitirá um maior grau de redistribuição de ranks entre as camadas. Alguns modelos pré-treinados podem ser mais sensíveis a uma redistribuição de ranks. Portanto, pode ser benéfico tentar rho=1.0 (sem redistribuição) se o desempenho for inferior ao esperado. - tau (
float) — Limiar de similaridade de cosseno para parada antecipada. Compara a similaridade de cosseno dos vetores singulares à direita entre duas etapas consecutivas de SVD. Se a similaridade de cosseno for superior a este limiar, a iteração do SVD é interrompida. O valor padrão é 0.99. - use_label_mask (
bool) — Use a máscara de rótulos para a inicialização do EVA. Isso significa que as posições em que labels=label_mask_value são ignoradas para o cálculo do SVD. Definir use_label_mask=True é preferível na maioria dos casos e pode ser especialmente benéfico para conversas de múltiplas rodadas. O valor padrão é True. Filtrar itens com base na máscara de rótulos pode, às vezes, levar a um tamanho de lote pequeno e, como resultado, instabilidades no cálculo do SVD. Para casos em que uma grande parte dos itens do lote seria filtrada, defina use_label_mask=False. - label_mask_value (
int) — Se use_label_mask=True, o valor a ser procurado para mascarar tokens ignorados. O padrão é -100. - whiten (
bool) — Aplica o branqueamento aos vetores singulares. O padrão é False. O branqueamento mostrou-se benéfico para o EVA no domínio da visão. - adjust_scaling_factors (
bool) — Ajusta os fatores de escala do LoRA após a redistribuição do rank. Definir isso como True significa que os fatores de escala são ajustados para que todos os gradientes do LoRA tenham a mesma escala, independentemente do seu rank. O padrão é True.
Esta é a classe de subconfiguração para armazenar a configuração de uma inicialização baseada em dados via EVA. O EVA foi introduzido em Explained Variance Adaptation.
initialize_lora_eva_weights
peft.initialize_lora_eva_weights
< source >( model: Moduledataloader: collections.abc.Iterable | None = Noneeva_state_dict: dict | None = Noneforward_fn: collections.abc.Callable | None = <function forward_fn_dict at 0x7f240ea44e00>prepare_model_inputs_fn: collections.abc.Callable | None = <function prepare_model_inputs_fn_language_modeling at 0x7f240ea44bf0>prepare_layer_inputs_fn: collections.abc.Callable | dict[str, collections.abc.Callable] | None = <function prepare_layer_inputs_fn_language_modeling at 0x7f240ea44d50>adapter_name: str = 'default'gather_distributed_inputs: bool = Trueshow_progress_bar: bool = True ) → model (torch.nn.Module)
Parâmetros
- model (PeftModel) — O modelo peft para o qual a SVD será calculada.
- dataloader (Optional[Iterable]) — O dataloader a ser usado para a passagem direta. Se for None, eva_state_dict precisa ser fornecido.
- eva_state_dict (Optional[dict]) —
O state_dict a ser carregado no modelo. Se for None, um dataloader precisa ser fornecido e o state_dict será
calculado usando
get_eva_state_dict. - forward_fn (Callable) —
A função de forward a ser usada para a passagem de forward. Recebe dois argumentos:
modeleinputs. O comportamento padrão éreturn model(**inputs) - prepare_model_inputs_fn (Optional[Callable]) —
Esta função recebe as entradas do modelo e o peft_config e passa a saída para
prepare_layer_inputs_fn. Pode ser usada para modificar a entrada do cálculo de SVD com base nas entradas originais do modelo. Por exemplo, para modelagem de linguagem, a máscara de atenção é usada para determinar quais índices são tokens de preenchimento e não devem ser usados para SVD. Qualquer função definida aqui espera dois argumentos:model_inputepeft_config.peft.tuners.lora.eva.prepare_model_inputs_fn_language_modelingé usado por padrão. - prepare_layer_inputs_fn (Union[Callable, Dict[str, Callable], None]) —
Esta função recebe as entradas da camada, as entradas do modelo (potencialmente modificadas por
prepare_model_inputs_fn) e o nome da camada e retorna as entradas que devem ser usadas para SVD para essa camada específica. Qualquer função personalizada definida aqui espera três argumentos:layer_input,model_inputelayer_namee deve retornar um tensor 2d. A lógica padrão pode ser encontrada em peft.tuners.lora.eva.prepare_layer_inputs_fn_language_modeling e funciona para modelagem de linguagem. Neste caso, model_inputs é a máscara usada para determinar quais índices devem ser usados para SVD (criada porprepare_model_inputs_fn_language_modeling). - adapter_name (str) — O nome do adaptador para inicializar os pesos.
- gather_distributed_inputs (bool) — Se deve reunir os inputs da camada de todos os ranks. O padrão é True, o que significa que, em um ambiente distribuído, os inputs da camada serão reunidos de todos os ranks para o cálculo do SVD. Em ambientes não distribuídos, este argumento é ignorado. Defina como False se estiver usando um dataloader não distribuído em um ambiente distribuído.
- show_progress_bar (bool) — Se deve exibir uma barra de progresso. O padrão é True.
Retorna
model (torch.nn.Module)
O modelo com os pesos LoRA inicializados.
Inicialize os pesos das camadas LoRA usando o método EVA.
Esta função inicializa os pesos das camadas LoRA usando o método EVA. Ela calcula a SVD para cada camada de adaptador e atualiza os pesos de acordo.
get_eva_state_dict
peft.get_eva_state_dict
< source >( model: Moduledataloader: Iterablepeft_config: peft.tuners.lora.config.LoraConfig | None = Noneforward_fn: collections.abc.Callable | None = <function forward_fn_dict at 0x7f240ea44e00>prepare_model_inputs_fn: collections.abc.Callable | None = <function prepare_model_inputs_fn_language_modeling at 0x7f240ea44bf0>prepare_layer_inputs_fn: collections.abc.Callable | dict[str, collections.abc.Callable] | None = <function prepare_layer_inputs_fn_language_modeling at 0x7f240ea44d50>adapter_name: str = 'default'gather_distributed_inputs: bool = Trueshow_progress_bar: bool = True ) → eva_state_dict (dict)
Parâmetros
- model (torch.nn.Module) — O modelo para o qual a SVD será calculada. Não precisa ser um PeftModel.
- dataloader (Iterable) — O dataloader a ser usado para a passagem direta.
- peft_config (Optional[LoraConfig]) —
A configuração das camadas LoRA. Obrigatório apenas se
modelnão for um PeftModel. - forward_fn (Callable) —
A função de forward a ser usada para a passagem de forward. Recebe dois argumentos:
modeleinputs. O comportamento padrão éreturn model(**inputs) - prepare_model_inputs_fn (Optional[Callable]) —
Esta função recebe as entradas do modelo e o peft_config e passa a saída para
prepare_layer_inputs_fn. Pode ser usada para modificar a entrada do cálculo de SVD com base nas entradas originais do modelo. Por exemplo, para modelagem de linguagem, a máscara de atenção é usada para determinar quais índices são tokens de preenchimento e não devem ser usados para SVD. Qualquer função definida aqui espera dois argumentos:model_inputepeft_config.peft.tuners.lora.eva.prepare_model_inputs_fn_language_modelingé usado por padrão. - prepare_layer_inputs_fn (Union[Callable, Dict[str, Callable], None]) —
Esta função recebe as entradas da camada, as entradas do modelo (potencialmente modificadas por
prepare_model_inputs_fn) e o nome da camada e retorna as entradas que devem ser usadas para SVD para essa camada específica. Qualquer função personalizada definida aqui espera três argumentos:layer_input,model_inputelayer_namee deve retornar um tensor 2d. A lógica padrão pode ser encontrada em peft.tuners.lora.eva.prepare_layer_inputs_fn_language_modeling e funciona para modelagem de linguagem. Neste caso, model_inputs é a máscara usada para determinar quais índices devem ser usados para SVD (criada porprepare_model_inputs_fn_language_modeling). - adapter_name (str) — O nome do adaptador para o qual a SVD será calculada.
- gather_distributed_inputs (bool) — Se deve reunir os inputs da camada de todos os ranks. O padrão é True, o que significa que, em um ambiente distribuído, os inputs da camada serão reunidos de todos os ranks para o cálculo do SVD. Em ambientes não distribuídos, este argumento é ignorado. Defina como False se estiver usando um dataloader não distribuído em um ambiente distribuído.
- show_progress_bar (bool) — Se deve exibir uma barra de progresso. O padrão é True.
Retorna
eva_state_dict (dict)
O dicionário de estado contendo os componentes SVD para cada camada.
Calcule a SVD para cada camada no modelo.
Esta função calcula a Decomposição em Valores Singulares (SVD) para cada camada do modelo. Ela utiliza o método de PCA incremental para calcular os componentes da SVD. A função também verifica a convergência dos componentes calculados usando a similaridade cosseno. A distribuição de posto para cada camada é determinada com base na razão de variância explicada.
LoraGAConfig
classe peft.LoraGAConfig
< source >( direction: Literal['ArBr', 'A2rBr', 'ArB2r', 'random'] = 'ArB2r'scale: Literal['stable', 'weight_svd', 'gd_scale', 'unit'] = 'stable'stable_gamma: int = 16 )
Parâmetros
- direction (
Literal["ArBr", "A2rBr", "ArB2r", "random"]) — Estratégia para distribuir os componentes do SVD do gradiente para as matrizes lora_A e lora_B.- “ArBr”: índices alternados (A assume os ímpares, B assume os pares)
- “A2rBr”: A assume os índices [r:2r], B assume os índices [:r]
- “ArB2r”: A assume os índices [:r], B assume os índices [r:2r] (recomendado)
- “random”: seleção aleatória de índices Padrão: “ArB2r”
- scale (
Literal["stable", "weight_svd", "gd_scale", "unit"]) — Estratégia de escala para a inicialização do adaptador.- “stable”: Escalonamento estável com parâmetro gamma
- “weight_svd”: Escala baseada nos valores singulares da matriz de pesos
- “gd_scale”: Escalonamento baseado em descida de gradiente
- “unit”: sem escala adicional Padrão: “stable”
- stable_gamma (
int) — Parâmetro gamma para o método de escalação estável. Padrão: 16
Esta é a classe de subconfiguração para armazenar a configuração para a inicialização do LoRA-GA.
LoRA-GA (Low-Rank Adaptation with Gradient Approximation) usa informações de gradiente durante a inicialização para alcançar uma convergência mais rápida (aceleração de 2 a 4x) alinhando os pesos iniciais do adaptador com a direção dos gradientes do fine-tuning completo.
Referência: https://arxiv.org/abs/2407.05000
Utilitários
peft.tuners.lora.loraga.estimate_gradients
< source >( model: Modulelora_config: LoraConfigtrain_step: Callable )
Estime os gradientes para a inicialização do LoRA-GA.
Esta função habilita o cálculo de gradientes APENAS nos pesos do módulo de destino e executa o callback train_step. Isso é mais eficiente em termos de memória do que habilitar gradientes globalmente.
peft.preprocess_loraga
< source >( model: Modulelora_config: LoraConfigtrain_step: Callablecache_file: str | None = None )
Parâmetros
- model (
nn.Module) — Modelo a ser pré-processado. - lora_config (
LoraConfig) — Configuração Lora do modelo.lora_config.lora_ga_configdeve ser definido. - train_step (
Callable[[], None]) — Callback para executar a estimativa de gradiente. Normalmente, você deve executar as passadas de forward e backward do modelo neste callback. Os gradientes serão acumulados entre todas as chamadas dentro deste callback. - cache_file (
Optional[str]) — Caminho opcional para o arquivo de cache para salvar/carregar gradientes. Se fornecido e o arquivo existir, os gradientes serão carregados do cache. Caso contrário, os gradientes serão estimados e salvos neste caminho.
Construa os campos necessários do LoRA-GA para um modelo estimando os gradientes.
Para cada camada linear, os gradientes serão estimados executando o callback train_step fornecido. Esses gradientes são então anexados aos módulos e usados durante a inicialização.
Ao concluir, os seguintes campos são definidos para cada módulo de destino:
_peft_loraga_grad (torch.Tensor):
Gradiente acumulado para a matriz de pesos.
Redução de Dimensão Intruder
peft.tuners.lora.intruders.reduce_intruder_dimension
< source >( peft_modelold_adapter_name = 'default'new_adapter_name = 'intruder_reduced'top_k = 10threshold_epsilon = 0.5mitigation_lambda = 0.75logging_sink = <built-in function print> )
Parâmetros
- peft_model —
O modelo PEFT com um adaptador LoRA carregado com o nome fornecido em
old_adapter_name. Atualmente, modelos mistos não são suportados. - top_k (padrão — 10) Considere as dimensões top-k para a detecção de intrusos. Quanto maior o valor, mais dimensões serão consideradas para a análise de detecção de intrusos (e maior será o número de falsos positivos). Opera sobre a similaridade de cosseno entre os pesos base e os pesos do adaptador, aproximadamente ordenados pela influência da dimensão (determinada pela decomposição em valores singulares), de modo que um top-k de 10 examinará as 10 dimensões mais “importantes”.
- threshold_epsilon (padrão — 0.5) Valor de limiar para considerar a similaridade cosseno entre o peso base e o peso do adaptador como intruso. De acordo com o artigo, as dimensões intrusas apresentam similaridade cosseno absoluta próxima de zero com os vetores singulares pré-treinados. Quanto menor esse valor, menos dimensões potenciais de intrusos são identificadas. Quanto maior o valor, mais falsos positivos potenciais são considerados intrusos.
- mitigation_lambda (padrão — 0.75) A porção relativa das dimensões do intruso que é subtraída do delta weight do adaptador. Quanto maior o valor, mais da dimensão do intruso é subtraída, mas mais informações são perdidas. Consulte a Figura 8 no artigo para uma análise de compensação.
- logging_sink (padrão — print) Função que imprime informações sobre o processo de mitigação. Defina como None se você não quiser nenhuma saída.
Mitigação da dimensão do intruso com base em https://huggingface.co/papers/2410.21228 (“LoRA vs Full Fine-tuning: An Illusion of Equivalence”).
Este método pode recuperar conhecimentos anteriores (ou seja, mitigar o esquecimento) por meio de pós-processamento de adaptadores de baixo posto já treinados. Isso ocorre a um custo em termos de precisão da tarefa - o ajuste do valor de migration_lambda pode ser usado para equilibrar esses dois fatores.
Após a mitigação, haverá um novo adapter com o nome definido em new_adapter_name, que também será definido como o adapter ativo atual. Portanto, a inferência no modelo mitigado usará o adapter modificado. Para voltar ao adapter original, você pode usar peft_model.set_adapter(<old_adapter_name>).
Atualmente, apenas o LoRA é suportado, pois não está claro se esse método se generaliza para outros métodos de pesos delta.