
PEFT documentation
BOFT
BOFT
Orthogonal Butterfly (BOFT) — это универсальный метод, разработанный для дообучения базовых моделей. Он повышает параметрическую эффективность парадигмы дообучения — Orthogonal Finetuning (OFT), — заимствуя идеи из быстрого преобразования Фурье Кули — Тьюки и демонстрируя хорошие результаты при дообучении различных базовых моделей, включая большие визуальные трансформеры, большие языковые модели и диффузионные модели «текст в изображение».
Аннотация из статьи:
Крупные фундаментальные модели становятся повсеместными, но обучение их с нуля обходится prohibitively дорого. Поэтому эффективная адаптация этих мощных моделей к задачам нижнего уровня приобретает всё большее значение. В данной статье мы изучаем обоснованный парадигму дообучения — Orthogonal Finetuning (OFT) — для адаптации к задачам нижнего уровня. Несмотря на демонстрацию хорошей обобщающей способности, OFT по-прежнему использует довольно большое количество обучаемых параметров из-за высокой размерности ортогональных матриц. Для решения этой проблемы мы начинаем с рассмотрения OFT с точки зрения передачи информации, а затем выделяем несколько ключевых требований, обеспечивающих лучшую эффективность по параметрам. Вдохновлённые тем, как алгоритм быстрого преобразования Фурье Кули — Тьюки обеспечивает эффективную передачу информации, мы предлагаем эффективную ортогональную параметризацию с использованием бабочковых структур. Мы применяем эту параметризацию к OFT, создавая новый метод дообучения с высокой эффективностью по параметрам, названный Orthogonal Butterfly (BOFT). Включая OFT как частный случай, BOFT вводит обобщённую рамку ортогонального дообучения. Наконец, мы проводим обширное эмпирическое исследование адаптации крупных vision transformers, крупных языковых моделей и text-to-image диффузионных моделей к различным задачам нижнего уровня в области зрения и языка.
BOFT ориентирован на сохранение генеративных возможностей предобученной модели, при этом демонстрируя значительно более высокую параметрическую эффективность по сравнению со стандартным OFT. Как и OFT, BOFT поддерживает одинаковую косинусную сходимость (hyperspherical energy) между всеми парами нейронов в слое, применяя ортогональное преобразование к матрице весов предобученной модели, что обеспечивает сохранение семантических связей между нейронами.
Вместо использования блочно-диагональной ортогональной матрицы BOFT разлагает ортогональное преобразование в произведение разреженных бабочковых матриц (изначально введённых в АДБ Кули–Тьюки). В отличие от блочно-диагональных вращений в OFT, которые смешивают входные данные только внутри каждого блока, структура бабочки гарантирует, что каждый вход может влиять на каждый выход, обеспечивая плотную связность всего с O(d log d) параметрами. Это разложение сохраняет выразительность модели, одновременно значительно сокращая количество параметров по сравнению с OFT (за счёт увеличения времени вычислений).
На практике BOFT умножает каждую предобученную матрицу весов на последовательность ортогональных факторов с бабочковой структурой, что обеспечивает эффективные и выразительные вращения нейронов. Это делает BOFT хорошо подходящим для управляемой генерации и задач, где критически важно сохранять представление предметной области предобученной модели, при этом позволяя масштабироваться на более крупные модели с меньшими затратами памяти и вычислительных ресурсов.
BOFT можно применять к любому подмножеству матриц весов в нейронной сети для уменьшения количества обучаемых параметров. Зная целевые слои для внедрения параметров BOFT, количество обучаемых параметров можно определить на основе размера матриц весов.
Обзор бенчмарков
Слияние весов BOFT с базовой моделью
Аналогично LoRA, веса, обученные с помощью BOFT, можно интегрировать в предобученные матрицы весов с помощью функции ~BOFTModel.merge_and_unload(). Эта функция объединяет веса адаптера с базовой моделью, что позволяет эффективно использовать новую объединенную модель как самостоятельную.
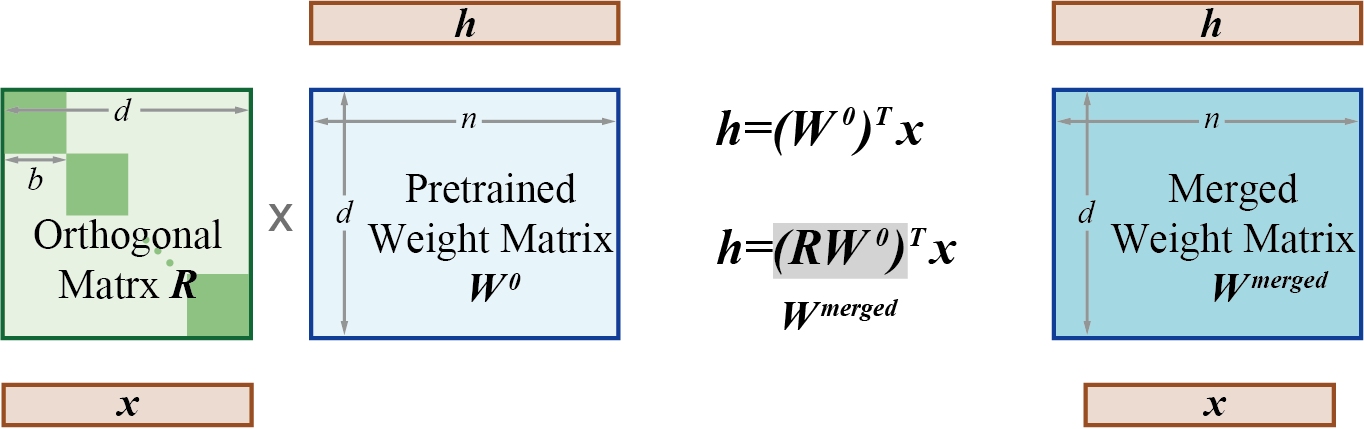
Это работает, потому что во время обучения ортогональная матрица весов (R на схеме выше) и предобученные матрицы весов остаются отдельными. Однако после завершения обучения эти веса можно фактически объединить (перемножить) в новую эквивалентную матрицу весов.
Пример использования BOFT
В качестве примера применения метода BOFT к различным задачам, см. следующие руководства:
Ознакомьтесь с пошаговыми руководствами о том, как дообучить модель с помощью BOFT:
Для задачи классификации изображений конфигурацию BOFT для модели DinoV2 можно инициализировать следующим образом:
import transformers
from transformers import AutoModelForSeq2SeqLM, BOFTConfig
from peft import BOFTConfig, get_peft_model

config = BOFTConfig(
    boft_block_size=4,
    boft_n_butterfly_factor=2,
    target_modules=["query", "value", "key", "output.dense", "mlp.fc1", "mlp.fc2"],
    boft_dropout=0.1,
    bias="boft_only",
    modules_to_save=["classifier"],
)

model = transformers.Dinov2ForImageClassification.from_pretrained(
    "facebook/dinov2-large",
    num_labels=100,
)

boft_model = get_peft_model(model, config)
API
BOFTConfig
класс peft.BOFTConfig
< source >( task_type: Optional[Union[str, TaskType]] = Nonepeft_type: Optional[Union[str, PeftType]] = Noneauto_mapping: Optional[dict] = Nonepeft_version: Optional[str] = Nonebase_model_name_or_path: Optional[str] = Nonerevision: Optional[str] = Noneinference_mode: bool = Falseboft_block_size: int = 4boft_block_num: int = 0boft_n_butterfly_factor: int = 1target_modules: Optional[Union[list[str], str]] = Noneexclude_modules: Optional[Union[list[str], str]] = Noneboft_dropout: float = 0.0fan_in_fan_out: bool = Falsebias: str = 'none'modules_to_save: Optional[list[str]] = Noneinit_weights: bool = Truelayers_to_transform: Optional[Union[list[int], int]] = Nonelayers_pattern: Optional[Union[list[str], str]] = None )
Параметры
- boft_block_size (
int) — размер блока матрицы BOFT для разных слоев, выраженный вint. Большие размеры блоков приводят к более плотным матрицам обновления с большим количеством обучаемых параметров. Выберитеboft_block_sizeтак, чтобы он делился на входное измерение большинства слоев (in_features), например, 4, 8, 16. Также укажите толькоboft_block_sizeилиboft_block_num, но не оба одновременно и не оставляйте оба равными 0, так какboft_block_sizexboft_block_numдолжно быть равно входному измерению слоя. - boft_block_num (
int) — Количество блоков BOFT на каждый внедряемый слой. Большие значенияboft_block_numприводят к более разреженным матрицам обновлений с меньшим количеством обучаемых параметров. Примечание: выберитеboft_block_numтак, чтобы он делился на размер входного пространства большинства слоёв (in_features), например, 4, 8, 16. Указывайте либоboft_block_size, либоboft_block_num, но не оба параметра одновременно и не оставляйте оба равными 0, так как произведениеboft_block_sizexboft_block_numдолжно быть равно размеру входного пространства слоя. - boft_n_butterfly_factor (
int) — Количество butterfly-факторов в разных слоях. Приboft_n_butterfly_factor=1BOFT совпадает с базовым OFT, а приboft_n_butterfly_factor=2эффективный размер блока OFT увеличивается вдвое, а количество блоков уменьшается вдвое. - target_modules (
Union[List[str],str]) — Имена модулей, к которым следует применить адаптер. - exclude_modules (
Optional[Union[List[str], str]]) — Имена модулей, к которым не следует применять адаптер. При передаче строки выполняется сопоставление по регулярному выражению. При передаче списка строк выполняется точное совпадение или проверяется, заканчивается ли имя модуля каким-либо из переданных строк. - boft_dropout (
float) — Вероятность мультипликативного dropout, при которой блоки OFT устанавливаются в тождественное преобразование во время обучения, аналогично слою dropout в LoRA. - fan_in_fan_out (
bool) — Установите это значение в True, если заменяемый слой хранит веса в формате (fan_in, fan_out). Например, gpt-2 используетConv1D, который хранит веса в формате (fan_in, fan_out), поэтому это значение должно быть установлено вTrue. - bias (
str) — Тип смещения для BOFT. Может принимать значения ‘none’, ‘all’ или ‘boft_only’. Если указано ‘all’ или ‘boft_only’, соответствующие смещения будут обновляться во время обучения. Обратите внимание, что это означает: даже при отключении адаптеров модель не будет выдавать тот же результат, что и базовая модель без адаптации. - modules_to_save (
List[str]) — список модулей, отличных от слоёв BOFT, которые нужно сделать обучаемыми и сохранить в итоговом контрольном пункте. - layers_to_transform (
Union[List[int],int]) — Индексы слоев для преобразования. Если этот аргумент указан, преобразования BOFT применяются к слоям с индексами, указанными в этом списке. Если передано одно целое число, преобразования BOFT применяются к слою с этим индексом. - layers_pattern (
Optional[Union[List[str], str]]) — Имя шаблона слоя, используется только еслиlayers_to_transformотличается отNoneи если шаблон слоя не входит в число общих шаблонов слоёв. Это должно указывать наnn.ModuleListмодели, который часто называется'layers'или'h'.
Это класс конфигурации для хранения конфигурации модели BOFTModel.
BOFTModel
класс peft.BOFTModel
< source >( modelpeft_config: Union[PeftConfig, dict[str, PeftConfig]]adapter_name: strlow_cpu_mem_usage: bool = Falsestate_dict: Optional[dict[str, torch.Tensor]] = None ) → torch.nn.Module
Параметры
- model (transformers.PreTrainedModel) — Модель, подлежащая адаптации.
- config (BOFTConfig) — конфигурация модели BOFT.
- adapter_name (
str) — имя адаптера, по умолчанию"default". - low_cpu_mem_usage (
bool,optional, по умолчаниюFalse) — Создаёт пустые веса адаптера на meta-устройстве. Полезно для ускорения процесса загрузки.
Возвращает
torch.nn.Module
Модель BOFT.
Создаёт модели BOFT и OFT на основе предобученной модели transformers. Статья: https://huggingface.co/papers/2311.06243 https://huggingface.co/papers/2306.07280
Пример:
>>> import transformers
>>> from peft import BOFTConfig, get_peft_model

>>> config = BOFTConfig(
...     boft_block_size=8,
...     boft_n_butterfly_factor=1,
...     target_modules=["query", "value", "key", "output.dense", "mlp.fc1", "mlp.fc2"],
...     boft_dropout=0.1,
...     bias="boft_only",
...     modules_to_save=["classifier"],
... )

>>> model = transformers.Dinov2ForImageClassification.from_pretrained(
...     "facebook/dinov2-large",
...     num_labels=100,
... )
>>> boft_model = get_peft_model(model, config)Атрибуты:
- model (transformers.PreTrainedModel) — Модель, подлежащая адаптации.
- peft_config (BOFTConfig): конфигурация модели BOFT.