
PEFT documentation
BOFT
BOFT
正交蝶形变换(BOFT)是一种专为微调基础模型而设计的通用方法。它从库利-图基快速傅里叶变换中汲取灵感,提升了微调范式——正交微调(OFT)——的参数效率,并在微调多种基础模型(包括大型视觉 Transformer、大型语言模型以及文本到图像扩散模型)中展现出良好的效果。
该论文的摘要如下:
大型基础模型正变得无处不在,但从头开始训练它们的成本极其高昂。因此,高效地将这些强大的模型适配到下游任务变得越来越重要。在本文中,我们研究了一种有原则的微调范式——正交微调(OFT)——用于下游任务适配。尽管 OFT 展示了良好的泛化能力,但由于正交矩阵的高维特性,它仍然使用了相当多的可训练参数。为了解决这个问题,我们首先从信息传输的角度审视 OFT,然后确定了几个能够实现更好参数效率的关键期望特性。受 Cooley-Tukey 快速傅里叶变换算法如何实现高效信息传输的启发,我们提出了一种使用蝶形结构的正交参数化方法。我们将此参数化应用于 OFT,创建了一种新颖的参数高效微调方法,称为正交蝶形(BOFT)。通过将 OFT 作为特例包含在内,BOFT 引入了一个广义的正交微调框架。最后,我们对将大型视觉 Transformer、大型语言模型和文本到图像扩散模型适配到视觉和语言领域的各种下游任务进行了广泛的实证研究
BOFT 专注于在保持预训练模型生成能力的同时,实现比标准 OFT 显著更高的参数效率。与 OFT 类似,BOFT 通过对预训练权重矩阵施加正交变换,维持同一层内所有神经元对之间的余弦相似度(超球面能量)不变,从而确保神经元之间的语义关系得以保留。
与使用块对角正交矩阵不同,BOFT 将正交变换分解为多个稀疏蝶形矩阵的乘积(该结构最初在Cooley–Tukey FFT中引入)。与 OFT 的块对角旋转仅在每个块内混合输入不同,蝶形结构确保每个输入都能影响每个输出,从而仅用 O(d log d) 个参数就实现了稠密连接。这种分解方式在大幅减少参数量(以计算时间为代价)的同时,保留了模型的表达能力。
在实践中,BOFT 将每个预训练权重矩阵乘以一系列具有蝶形结构的正交因子,从而实现高效且富有表达力的神经元旋转。这使得 BOFT 非常适合可控生成以及需要保持预训练模型主题表示的任务,同时也能以较低的内存和计算开销扩展到更大的模型。
BOFT 可以应用于神经网络中权重矩阵的任意子集,以减少可训练参数的数量。在给定用于注入 BOFT 参数的目标层后,可以根据权重矩阵的规模来确定可训练参数的数量。
基准测试概览
将 BOFT 权重合并到基础模型
与 LoRA 类似,BOFT 学习到的权重可以通过 ~BOFTModel.merge_and_unload() 函数整合到预训练权重矩阵中。该函数将适配器权重与基础模型合并,从而允许您将新合并的模型作为独立模型有效使用。
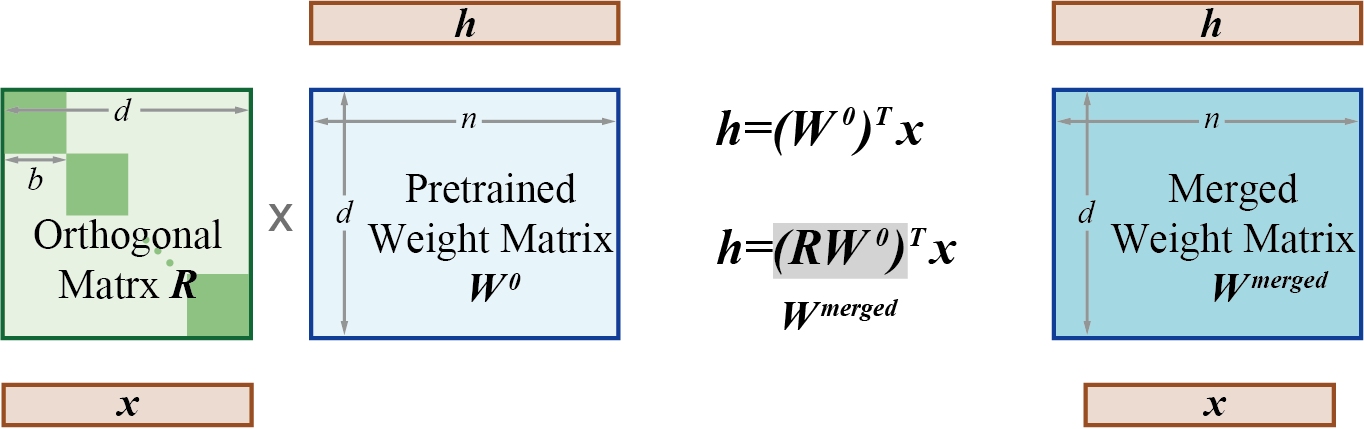
这之所以可行,是因为在训练过程中,正交权重矩阵(即上图中的 R)与预训练权重矩阵是相互独立的。但训练完成后,这些权重实际上可以被合并(相乘)为一个等效的新权重矩阵。
BOFT 使用示例
有关 BOFT 方法应用于各种下游任务的示例,请参阅以下指南:
请查看以下关于如何使用 BOFT 微调模型的逐步指南:
对于图像分类任务,可以按如下方式为 DinoV2 模型初始化 BOFT 配置:
import transformers
from transformers import AutoModelForSeq2SeqLM, BOFTConfig
from peft import BOFTConfig, get_peft_model

config = BOFTConfig(
    boft_block_size=4,
    boft_n_butterfly_factor=2,
    target_modules=["query", "value", "key", "output.dense", "mlp.fc1", "mlp.fc2"],
    boft_dropout=0.1,
    bias="boft_only",
    modules_to_save=["classifier"],
)

model = transformers.Dinov2ForImageClassification.from_pretrained(
    "facebook/dinov2-large",
    num_labels=100,
)

boft_model = get_peft_model(model, config)
API
BOFTConfig
类 peft.BOFTConfig
< source >( task_type: Optional[Union[str, TaskType]] = Nonepeft_type: Optional[Union[str, PeftType]] = Noneauto_mapping: Optional[dict] = Nonepeft_version: Optional[str] = Nonebase_model_name_or_path: Optional[str] = Nonerevision: Optional[str] = Noneinference_mode: bool = Falseboft_block_size: int = 4boft_block_num: int = 0boft_n_butterfly_factor: int = 1target_modules: Optional[Union[list[str], str]] = Noneexclude_modules: Optional[Union[list[str], str]] = Noneboft_dropout: float = 0.0fan_in_fan_out: bool = Falsebias: str = 'none'modules_to_save: Optional[list[str]] = Noneinit_weights: bool = Truelayers_to_transform: Optional[Union[list[int], int]] = Nonelayers_pattern: Optional[Union[list[str], str]] = None )
参数
- boft_block_size (
int) — 不同层中 BOFT 矩阵的块大小,以int表示。块大小越大,更新矩阵越密集,可训练参数也越多。请选择能被大多数层的输入维度(in_features)整除的boft_block_size,例如 4、8、16。此外,请仅指定boft_block_size或boft_block_num其中之一,不要同时指定两者,也不要将两者都设为 0,因为boft_block_sizexboft_block_num必须等于该层的输入维度。 - boft_block_num (
int) — 每个注入层中的 BOFT 块数量。较大的boft_block_num会导致更新矩阵更稀疏,更少的可训练参数。注意,请选择boft_block_num使其能被大多数层的输入维度(in_features)整除,例如 4、8、16。请仅指定boft_block_size或boft_block_num其中之一,不要同时指定两者,也不要将两者都设为 0,因为boft_block_sizexboft_block_num必须等于该层的输入维度。 - boft_n_butterfly_factor (
int) — 不同层之间的蝴蝶因子数量。当boft_n_butterfly_factor=1时,BOFT 与原始 OFT 相同;当boft_n_butterfly_factor=2时, OFT 的有效块大小变为原来的两倍,而块的数量则减半。 - target_modules (
Union[List[str],str]) — 要应用适配器的模块名称。 - exclude_modules (
Optional[Union[List[str], str]]) — 不应用适配器的模块名称。传入字符串时,将执行正则表达式匹配。传入字符串列表时,将执行精确匹配,或检查模块名称是否以传入的任一字符串结尾。 - boft_dropout (
float) — 乘性 dropout 概率,通过在训练期间将 OFT 块设置为恒等变换来实现,类似于 LoRA 中的 dropout 层。 - fan_in_fan_out (
bool) — 如果待替换的层以 (fan_in, fan_out) 的形式存储权重,请将此项设置为 True。 例如,gpt-2 使用Conv1D,其权重以 (fan_in, fan_out) 的形式存储,因此应将其设置为True。 - bias (
str) — BOFT 的偏置类型。可以是 ‘none’、‘all’ 或 ‘boft_only’。如果设置为 ‘all’ 或 ‘boft_only’,对应的偏置将在训练期间被更新。请注意,这意味着即使禁用了适配器,模型的输出也不会与未进行适配的基础模型相同。 - modules_to_save (
List[str]) — 除 BOFT 层外,需要设置为可训练并在最终检查点中保存的模块列表。 - layers_to_transform (
Union[List[int],int]) — 要转换的层索引。如果指定了此参数,则会对列表中指定的层索引应用 BOFT 转换。如果传入单个整数,则会对该索引处的层应用 BOFT 转换。 - layers_pattern (
Optional[Union[List[str], str]]) — 层模式名称,仅在layers_to_transform不同于None且层模式不在通用层模式中时使用。它应指向模型的nn.ModuleList,通常命名为'layers'或'h'。
这是用于存储 BOFTModel 配置的类。
BOFTModel
类 peft.BOFTModel
< source >( modelpeft_config: Union[PeftConfig, dict[str, PeftConfig]]adapter_name: strlow_cpu_mem_usage: bool = Falsestate_dict: Optional[dict[str, torch.Tensor]] = None ) → torch.nn.Module
参数
- model (transformers.PreTrainedModel) — 要适配的模型。
- config (BOFTConfig) — BOFT 模型的配置。
- adapter_name (
str) — 适配器的名称,默认为"default"。 - low_cpu_mem_usage (
bool,optional, defaults toFalse) — 在 meta 设备上创建空的适配器权重。有助于加快加载过程。
返回值
torch.nn.Module
BOFT 模型。
从预训练的 transformers 模型创建 BOFT 和 OFT 模型。论文:https://huggingface.co/papers/2311.06243 https://huggingface.co/papers/2306.07280
示例:
>>> import transformers
>>> from peft import BOFTConfig, get_peft_model

>>> config = BOFTConfig(
...     boft_block_size=8,
...     boft_n_butterfly_factor=1,
...     target_modules=["query", "value", "key", "output.dense", "mlp.fc1", "mlp.fc2"],
...     boft_dropout=0.1,
...     bias="boft_only",
...     modules_to_save=["classifier"],
... )

>>> model = transformers.Dinov2ForImageClassification.from_pretrained(
...     "facebook/dinov2-large",
...     num_labels=100,
... )
>>> boft_model = get_peft_model(model, config)属性:
- model (transformers.PreTrainedModel) — 要适配的模型。
- peft_config (BOFTConfig): BOFT 模型的配置。